企業法務マンサバイバル

企業法務を中心とした法律に関する本・トピックのご紹介を通して、サバイバルな時代を生きるすべてのビジネスパーソンに貢献するブログ。

_リーガルテック

「司法にAIはまだ早い」という前に ―宍戸研究会取りまとめへの感銘と、最高裁のAI検証方法に対する疑問

 
商事法務研究会が公表した「AI時代における民事司法を考える研究会 取りまとめ」を読みました。

司法とAIというテーマから、多くの方が想像するのは、ハルシネーション、バイアス、ブラックボックス、裁判官の独立といった懸念を一通り並べた上で、結局は「人間が責任をもって慎重に検討する必要がある」と締めくくる、そんな予定調和の報告書ではないでしょうか。

もちろん本報告書にも、そうした論点が網羅されています。しかし全体を読んで私が感じたのは、むしろ逆でした。宍戸常寿・東京大学教授が座長を務める本研究会では、まだ扱いづらい技術であるAIを、憲法上・訴訟法上の制約を確認しながらも、少しでも民事司法に役立てられないかという姿勢が一貫していたのです。

報告書は、AIによって争点整理を充実・迅速化し、司法アクセスを拡充し、法律実務家を中核的な仕事へ振り向けることができると整理した上で、民事司法の標準化・均質化・安定化や、裁判所・法律実務家という限られた社会資源の再配分にもつながるとして、AI活用には「積極的な意義がある」と評価しています。AIを使うこと自体を危険視するところから議論を始めず、国民にとって司法が早く、安く、使いやすくなる可能性を、便益として正面から認めるものとなっています。
ai-shihoukenkyukai-1

「AI裁判官」をタブーにしなかった研究会


本報告書の良さは、参加した学者の意見について、AIに対して肯定的なものも否定的なものもそれぞれ率直に併記されている点にあります。

たとえば、過去のデータから統計的な出力を行うAIは、少数者に対する構造的な権利侵害を増幅・固定化するおそれがあり、開発者の価値判断からも逃れられないとの意見が紹介されています。これに対し、人間の判断こそ過去の経験の積み重ねではないか、むしろ構造的な権利侵害を是正する方向でAIを使うことも考えられる、という反論も載っています。AIは判断過程を見通せないブラックボックスだとの批判に対しても、「人間の判断もブラックボックス」であり、確率モデルであることと出力が揺れることは別の問題だ、との応答が記録されています。反対論を形式的に載せただけではなく、その反対論に対する再反論まで残したところに、この研究会の姿勢がよく表れています。

そして報告書は、現時点では裁判官の判断をAIに代替させることを想定しないと確認しながら、技術の進歩と社会の受け止め方が変わる可能性を踏まえ、「あえて思考実験として」、AIに司法作用を代替させる方向性まで検討しています。最終的には、人間である裁判官が当事者と向き合い、自ら責任を負って裁判を行うべきだとの結論に戻ります。しかし、ここで重要なのは、その結論そのものよりも、「憲法上あり得ない」「人間の尊厳に反する」と入口で封印せず、いったん最後まで考えようと試みている点です。

司法制度を守るためにAIを遠ざけるのではなく、AIと人間を比べることで、そもそも人間の裁判官が行う司法の価値とは何かを問い直す。思考実験と言いつつ、かなり攻めた内容です。

日本総研が設計し、最高裁が検証した別添5に感じた違和感


一方で、報告書の最後に添付された「最高裁検証結果」(別添5)については、報告書全体を通底する前向きな議論とは異質な空気が漂います。

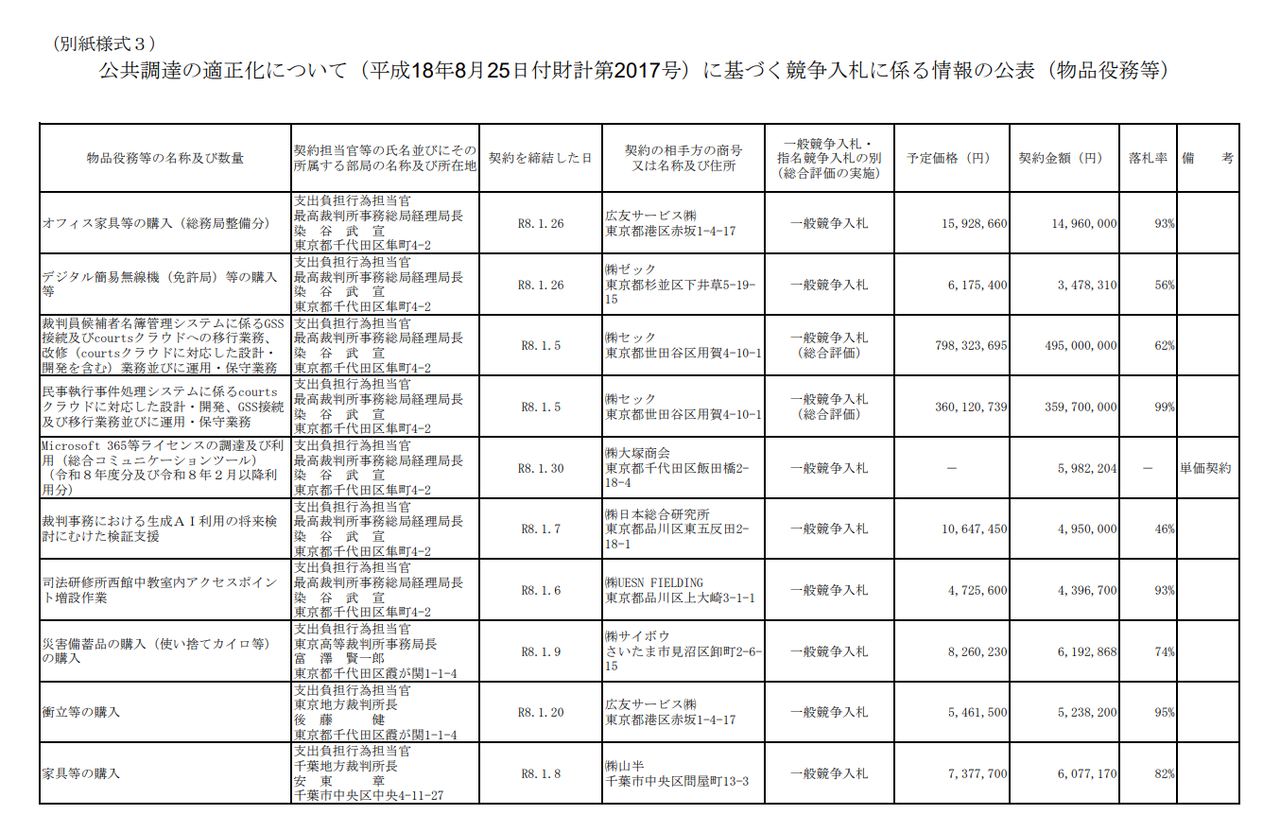
この検証は、東京地裁・大阪地裁で民事訴訟を担当する中堅裁判官6人が、模擬記録を用いて、生成AIを争点整理の補助に使えるかを試したものです。最高裁の契約情報によれば、日本総合研究所が「裁判事務における生成AI利用の将来検討にむけた検証支援」を495万円で受託しています。
ai-shihoukenkyukai-3

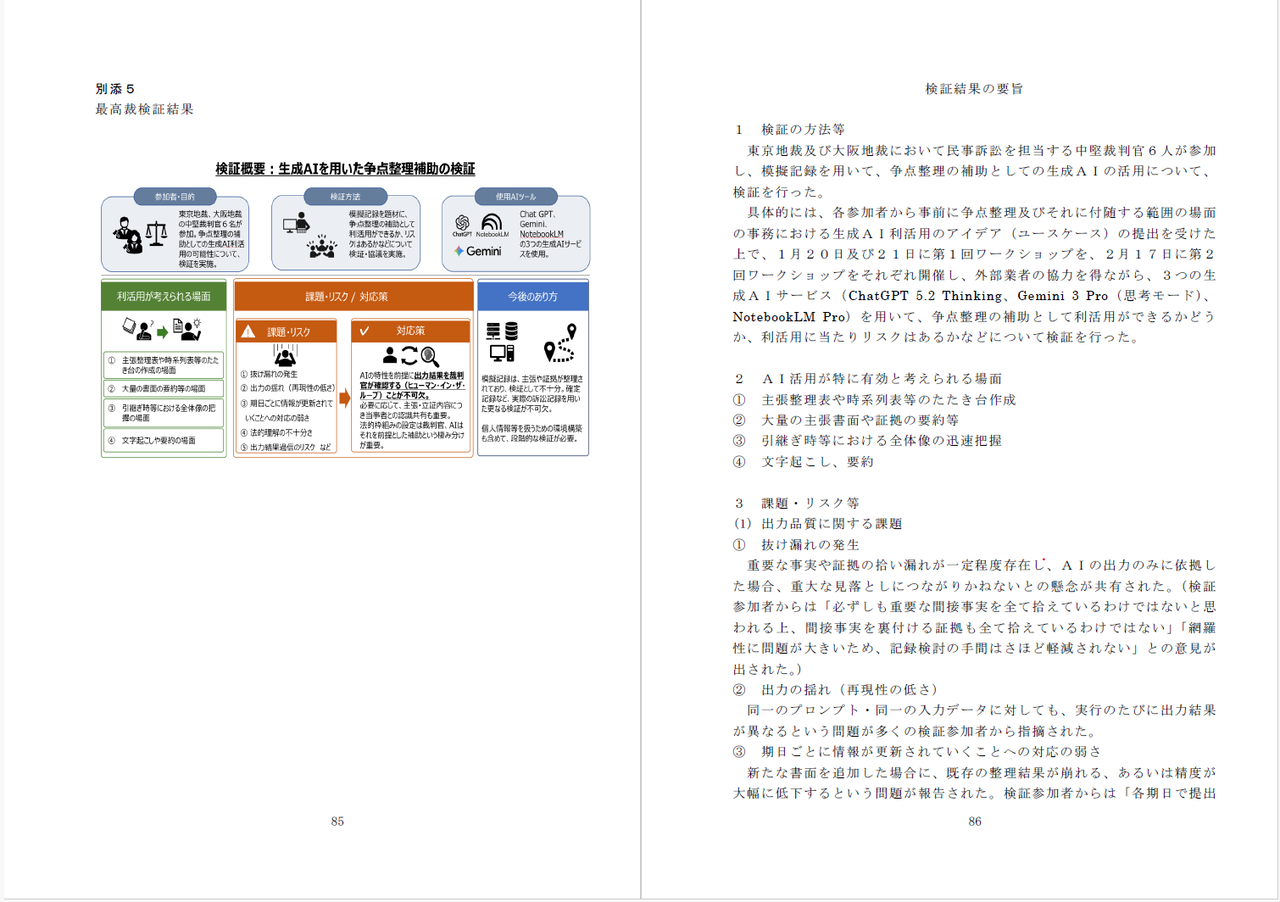
この別添5では、主張整理表や時系列表のたたき台、大量の書面・証拠の要約、引継ぎ時の全体把握などには有効としながら、事実・証拠の拾い漏れ、出力の揺れ、書面を追加した際の精度低下、要件事実や抗弁構造に対する理解不足が指摘され、そこから生成AIの法的推論能力の限界まで示唆するまとめ方がされています。

裁判業務にまだよく分からないAI技術を導入し生産性を上げろと迫らんばかりの勢力に対し、裁判所自身が慎重な態度であろうとすることは分かります。裁判官の判断は、企業の社内業務の効率化とは違い、当事者の権利義務を終局的に確定するものです。便利そうだから、とりあえず使ってみようというわけにはいきません。

しかし、それを踏まえても、私はこの別添5に書かれたAI評価には率直な違和感を覚えました。その理由を突き詰めていくと、問題は裁判所の頭が硬いとか、裁判官が新技術を嫌っているといったことではなく、今回のAI活用検証を行った環境設定、日本総研が受託者としてお膳立てをした検証の方法にあります。

検証に使われたAIは、

・ChatGPT 5.2 Thinking
・Gemini 3 Pro(思考モード)
・NotebookLM Pro

の三つ。このラインナップを見たとき、なぜGoogle製品を二つも入れたのだろう、なぜリーガル特化のAIツールを加えなかったのだろう、と思わざるをえませんでした。特に気になったのが、ChatGPTやGeminiという汎用モデルと、NotebookLMを同じ列に並べて検証環境を設計したことです。

NotebookLM(2026年7月16日に製品名を「Gemini Notebook」を改称)は、ユーザーが与えた文献や資料に回答をグラウンディングし、引用箇所を示しながら、その内容を検索・要約・整理することを得意とするリサーチ用のアプリケーションです。もちろん現在のNotebookLMは高度化しており、単純な要約機能だけではありません。それにしても、Geminiと、Geminiを用いて資料参照型のワークフローを実装したNotebookLMを並べるのは、エンジンと、そのエンジンを積んだ特定用途の車を同じ条件で走らせるようなものです。NotebookLMに訴訟記録を読ませること自体は適切でも、そこから法的推論一般の限界を測ろうとしたのであれば、道具の選び方と評価したい能力がずれています。

さらに、公開された別添5からは、どのようなプロンプトを与えたのか、訴訟記録をどう分割して入力したのか、モデルにどこまでのコンテキストを持たせたのか、要件事実・法的枠組み・文献を参照情報として与えたのか、各製品の出力をどの基準で比較したのかが不明です。生成AIは、同じ製品名であっても、資料の与え方、プロンプト、検索・参照の設計によって結果が大きく変わります。そこを明らかにしないまま、拾い漏れや出力の揺れを法的推論能力一般の限界にまで広げるのは、評価の方法の設計が粗いように思います。

しかも別添5自身、実務上のリスクに関する参加者の評価については、「注意すれば使用可能」が大勢だったと記しています。つまり、6人の裁判官がAIを触ってみた結果そのものが、全面的に否定的だったわけではありません。今回確認できたのは「現在の製品を、今回設定された環境と使い方で動かした場合の限界」であって、生成AI活用の限界ではないはず。そう疑問を抱かざるを得ない内容に見えました。
ai-shihoukenkyukai-2

�“塾稱幻ツ敢此Ν∨‥�分析・��事実認定に分けて評価


さて、宍戸研究会の本論に話を戻します。

報告書では、司法におけるAI利活用の場面を�“塾稱幻ツ敢此Ν∨‥�分析・��事実認定と大きく三つに分けた上で、それぞれのシーンでの可能性を分析しています。この部分に関しては1人の読者として、同意できる点・できない点がそれぞれありました。

まず�,糧塾稱幻ツ敢困砲弔い討蓮∧鷙霆颪侶誅世貌碓佞任后A任糧突�LLMを法律業務に使い、存在しない判例を生成した事例を見て「生成AIはリーガルリサーチには使いものにならない」と断じる専門家は少なくありません。ただし、それは専門の判例データベースにもつながず、原典確認の仕組みも付けないままの素のLLMを評価しているケースがほとんどです。今回の報告書も、裁判例・文献に法的素養のある専門家がアノテーションを付し、それをRAGで参照させ、回答とともに根拠資料を提示する仕組みを現実的な方向性として挙げ、この領域に関しては関係者一同大きな異論もなく活用できると結論づけています。

つづく�△遼‥�分析場面でのAI活用に対し、報告書は全体として厳しい評価を下しています。しかし私はもう少し楽観的です。報告書は、法律構成や要件事実を裁判例から抽出してアノテーションする難しさや、法的分析に唯一の「正解」がないことを課題として挙げています。しかし同時に、正解を一つに決める必要はなく、複数の結論を出力させてもよいとの意見も紹介し、民事裁判情報データベースによって利用可能な裁判例が増えれば、法的分析機能を実装できる可能性は高まるとも認めています。複数の法律構成と、その根拠、弱点、追加で確認すべき事実をAIに提示させ、人間が選択するのであればよい。法的分析は、原理的にAIにはできない仕事ではなく、データと評価方法をどう作るかという、時間と投資の問題ではないかと考えます。

一方、��の事実認定について、報告書が、まだ具体的な実装を検討する段階にはないとしたことには同意します。司法の役割は、対立する証拠の中から何が起きたのかを裁判所が確定し、事前に定めたルールに従って、その認定に国家として強制力を与える点にあるのだと捉えています。ここにおいて書面を要約し、時系列を作り、供述の矛盾を指摘し、複数の仮説を並べるところまでは、AIに手伝わせることも可能でしょう。しかし、どの供述を信用し、どの間接事実を重く見て、逆に何が存在しないことに意味を認めるかといった判断には、当事者との対話・証拠が作られた文脈・裁判官が法廷で受け取った印象まで盛り込んで、ようやく到達できるものです。整った文章を出すAIほど、証明されていない一つのストーリーを、もっともらしい事実として固定してしまう危険もあります。この部分をAIに代替させることには、法的分析とは質の違う慎重さが必要となるでしょう。

AIの評価は正しいツールを正しく使ってから


報告書は、インドのSUPACE、ブラジルのSocrates、シンガポールのODR支援ツールなど、海外の利用事例も幅広く整理しています。とはいえ、海外事例を把握していることと、現在のフロンティアモデルがどこまで推論でき、モデル・データベース・RAG・アプリケーションをどう組み合わせれば望ましい性能が出るのかを理解していることは別です。この研究会に参加した全員が、現在のAIの本当の実力と限界を同じ解像度で共有した上で議論していたのかについては、別添5に感じた違和感も相まって、若干の疑問が残ります。

それでも、報告書本体が、憲法上の制約や裁判官の独立を盾にして議論を止めず、宍戸座長のリーダーシップの下で「AIを司法に入れてよいか」ではなく「どのような条件ならどこまで使えるか」をポジティブに考え続けていた点は、感銘を受けました。

このような技術的側面と法的・実務的側面を架橋した双方向での議論は、AIに司法の作用を代替させることができるのか、AIではなく、人が裁判を行う意義は何か、といった基本的かつ根源的な論点についての議論を深めることにもつながるものであった。また、この議論の中では、法律実務家及び学術研究者にとって自己弁護的なものとなってはならず、当事者・国民にとってどのように受け止められるのかを意識すべきである、民事司法分野におけるAIの利活用が民事訴訟の充実化・迅速化、司法アクセスの維持・拡充など、当事者・国民にとって便益につながっているかにまで遡った検討が必要である、といった指摘も繰り返しなされたところである。

最終盤の67ページに記されたこの一文が、本研究会および本報告書全体の姿勢を最もよく表しています。人間の裁判官や法律実務家にしかできないことを守るためにも、AIに何ができるのか、正確に把握しなければならないフェーズが今だと考えます。


先生の事務所もAIを使ってらっしゃいますよね? ―隠せなくなったタイムチャージの「嘘」

私が参加している法務パーソンのコミュニティで、ある方から、次のような問いかけがありました。

生成AIの登場によって、法務業務にかかる時間は減った企業がほとんどかと思います。しかしながら、タイムチャージ型の法律事務所からの1案件あたりの請求額は減ってないことが多いように思います。(中略)法律事務所では依頼案件数の減少分を取り戻すべく、1案件にアサインする弁護士数を増やしたりして請求額を維持しているようにも思います。

みなさんの企業の取引先のタイムチャージ型法律事務所では、生成AIを活用したことによって弁護士の稼働時間が減り1案件あたりの請求額が顕著に減った法律事務所の事例ってあったりしますかね?

なかなか答えにくい質問です。もちろん、個別の法律事務所が、請求額を維持するために不要な弁護士をアサインしていると断定することはできません。AIを使っても、出力の検証、法的評価、クライアントへの説明、そして判断を誤った場合の責任まで消えるわけではないからです。

それでも、この書き込みが企業法務パーソンの実感を捉えていることは否定しにくいでしょう。企業内では、生成AIによってリサーチ、契約書比較、論点整理、ドラフト作成にかかる時間が目に見えて減っている。それなのに、法律事務所から届く請求書には、相変わらずパートナー数時間、アソシエイト十数時間と記載され、総額もほとんど変わらない。

クライアントはすでに気づき始めています。タイムチャージは、本当に「かかった時間」の値段だったのだろうか、と。

価値に課金したいのに、時間に課金した顔をする


ここでいうタイムチャージの「嘘」とは、架空の稼働時間を計上しているという意味ではありません。価値に対して報酬を得たいはずの法律事務所が、時間に対する請求であるかのような外形を維持している、という構造上の矛盾です。

83227848-DA0A-4241-954E-1E3104102B66

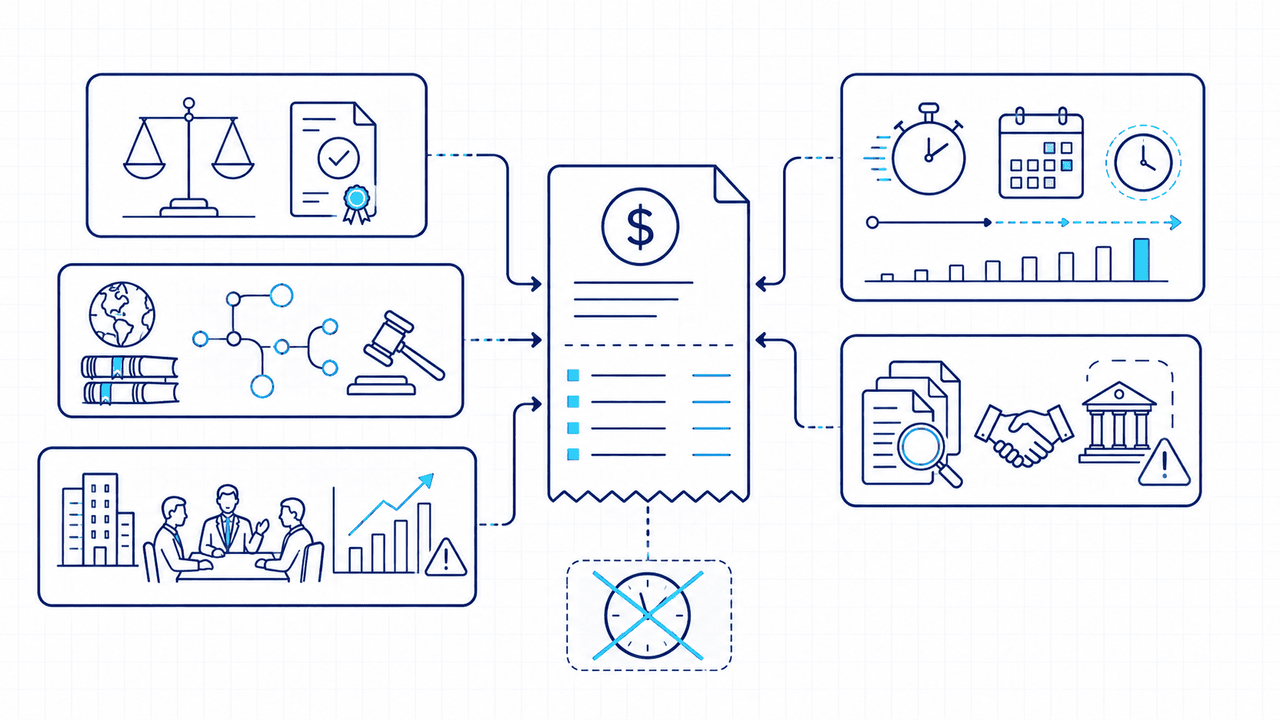
企業が外部法律事務所へ案件を持ち込むのは、通常、企業内法務だけでは処理しきれない専門性、経験、独立性が必要だからです。顧客が外部弁護士に問うのは、たとえば次のような問題です。

  • このデューデリジェンスで発見された法的リスクは、買収価格と事業シナジーに照らして許容できるのか。価格調整、補償条項、クロージング前提条件、ディールからの撤退のうち、どの手段で処理すべきか。
  • 競争法当局が問題視する論点に対し、どこまで問題解消措置を提示すれば、事業価値を毀損せずにクリアランスの可能性を高められるのか。
  • 大型訴訟について、勝敗の見通しだけでなく、判決までの費用、事業への拘束、レピュテーション、将来の類似請求への波及まで考慮すると、どの水準で和解するのが合理的なのか。

ここで顧客が購入しているのは、判例を検索した時間でも、証拠を読んだページ数でもありません。高度で不確実な法的リスクについて、経営が選択可能な形まで評価を絞り込む能力です。

従来、時間はこの価値を測るための代理指標として、そこそこよく機能していました。複雑な案件ほど調査と検討に時間がかかり、経験豊富な弁護士ほど時間単価も高い。「単価 × 時間」には一定の合理性があったわけです。

ところが生成AIは、時間と価値との結び付きを急速に弱めます。数百件の契約書から特定条項を抽出する。大量の証拠から時系列を作る。各国法制の初期調査を行う。過去案件のメモを検索し、論点表やドラフトを作成する。こうした作業時間が大幅に短くなっても、案件の重要性、法的判断の難しさ、弁護士が負う責任は小さくなりません。

そうであれば、「時間が減ったのに、なぜ料金は下がらないのか」という顧客の問いに対し、専門性、判断、責任、独立した評価に価格を付けているのだと説明すべきです。それをせず、時間が価値であるかのような請求書を出し続ければ、AIで減った時間が別の作業名や追加アサインに置き換えられているのではないかと疑われるのも致し方ないでしょう。

説明されない請求額は、いずれすべて水増しに見え始めます。法律事務所にとって本当に危険なのは、AIに作業を奪われることではなく、顧客から請求書の正当性を信用されなくなることです。

企業内法務が売る「速度」と、外部弁護士が売る「速度」は違う


私は先の記事(法務部が早く帰れたか、ではなく事業部が早く動けたか ―AI導入効果を測る最上位KPIは「法務待ち時間」の解消)で、企業内法務のAI導入効果は、「法務担当者の作業時間」ではなく「事業部門が法務を待つ時間」で測るべきだ、と書きました。

企業内法務の価値は、反復して発生する法律判断を事業プロセスへ組み込み、会社全体が止まらずに動ける状態を作ることにあります。定型案件をセルフサービス化し、必要な情報を早期に集め、暫定判断を返し、難しい案件だけを適切にエスカレーションする。そこで求められる速度とは、法務サービスを社内へ広く、滞りなく供給する速度です。

これに対して、外部法律事務所へ期待される価値は、単に顧客を「次の行動へ移れる状態」にすることだけではありません。それだけなら、企業内法務の延長にすぎないからです。外部弁護士に求められるのは、社内では確定できない高度な法的リスクについて、専門知識、類似案件の経験、当局や裁判所の実務感覚、そして組織から独立した第三者的視点を用いて、経営が引き受けられる判断へと収束させることです。法務部門が案件を前へスムーズに流す役割に軸足があるのに対し、外部法律事務所は、企業内では解像できない不確実性に線を引く役割を担います。

したがって、両者の「速度」は意味が異なります。企業内法務が追求するのは、会社全体の法務待ち時間を減らすオペレーション上の速度です。外部弁護士が売るべきなのは、重要な経営判断を左右する法的リスクについて、十分な根拠と説明可能性を備えた結論へ到達する速度です。

M&Aの入札期限、当局への届出、取締役会、記者発表、訴訟上の期限を前に、経営が取り得る選択肢を一日早く確定することには、それ自体に経済的価値があります。遅れて提出された精緻な意見書よりも、意思決定期限の前に示された根拠のあるリスクジャッジのほうが価値は高いはずです。

どのようにして脱タイムチャージを実現するかーーAI時代の法律事務所の請求額計算法


「時間ではなく価値に課金する」と言うだけでは、料金体系としては何も決まりません。取引額の何%、回避した損失の何%といった成功報酬も、弁護士の貢献だけを切り分けにくく、すべての企業法務案件に適用できるものではないでしょう。

そこで、AI時代の法律事務所の請求額を、次のように設計・計算してはどうでしょうか。

請求額 = 基礎判断料 × 法的難度係数 × 経営影響係数 × 期限係数 + 追加スコープ料金

「基礎判断料」:作業内容ではなく、クライアントに提供する判断の単位ごとに設定します。M&Aのデューデリジェンスであれば、「重要な法的リスクを特定し、価格調整、補償、クロージング前提条件、撤退のいずれで処理すべきかを提示する」ところまでを一つの商品とする。大型紛争なら、「勝敗の見通し、コスト、事業への影響を踏まえ、訴訟継続と和解条件の選択肢を提示する」ところまでを一つの判断単位とします。レビューした文書数や作成したメモの枚数ではなく、経営が何を決められる状態になるかによって標準価格を置くわけです。

「法的難度係数」:先例の乏しさ、法解釈の不確実性、対象法域の数、当局裁量の大きさ、事実関係の複雑さなどを反映します。同じデューデリジェンスでも、国内の単純な資産取得と、多数国にまたがる規制産業の買収とでは、判断の難しさが違います。例えば、標準案件を1.0、当事務所独自の専門性を要する案件を1.3、複数分野の専門家を束ねなければ判断できない案件を1.8とする、といった設計です。

「経営影響係数」:その判断を誤った場合の影響、意思決定の不可逆性、取引や事業の重要度を反映します。これは単純に取引額へ比例させるものではありません。同じ100億円の取引でも、補償で処理できるリスクと、買収後の中核事業を継続できなくなるリスクでは、判断の重みが違うからです。経営会議や取締役会が、どの程度そのリーガルジャッジに依拠するのかを価格へ組み込みます。

「期限係数」:AI時代の料金体系で最も重要なのがこれかもしれません。標準納期を係数1.0とし、通常10営業日を要する分析を5営業日で提示するなら1.2、3営業日なら1.5、翌営業日なら2.0とする。これは、弁護士が深夜まで働いた時間への割増料金ではありません。重要な専門家チームを優先的に確保し、クライアントが一日でも早く経営判断を確定できることへのプレミアムです。

例えば、基礎判断料を300万円、法的難度係数を1.4、経営影響係数を1.3とした案件なら、標準納期での料金は546万円となります。これを通常10営業日のところ4営業日で提示する期限係数1.5の案件とすれば、請求額は819万円です。従来のタイムチャージでは、AIを使って作業時間が短くなれば請求額も下がるはずでした。この方式では、AIと蓄積されたナレッジによって高度な判断を早く提供できるほど、むしろ料金は上がります。

前提としていた対象会社や法域が追加された、調査中に新たな不正が発見された、当局対応や契約交渉まで依頼範囲が広がった場合には、「追加スコープ料金」を請求します。見積時に判断単位、前提条件、納期、追加料金が発生する条件を明示しておけば、クライアントにとっても予算の予測可能性は、タイムチャージより高くなります。

F6F86D48-EA65-4D18-993C-5CB901F3B5E5

いわゆる顧問契約については、一定時間内に専門家チームへアクセスできる「可用性料金」と位置付けるべきでしょう。月額の可用性料金に、重要案件ごとの判断料を組み合わせる。何時間まで無料という設計ではなく、どの専門家が、どの期限で、どのレベルの判断を提供するかを契約します。

なお、これらの料金体系を採用しても、法律事務所はタイムシートを取り続けて構いません。いやむしろそうすべきです。ただし、その時間記録の用途はこれまでとは違います。案件ごとの採算を把握し、標準価格を改善し、追加スコープの発生を検知するための内部管理情報として使う。弁護士の時間は請求単位ではなく、法律事務所の原価であると整理するわけです。

生成AIを使用したから値引きし、使用しなかったから高くするという話でもありません。AIは、法律事務所が価値を生産するための設備にすぎない。クライアントが購入するのはAIの使用時間ではなく、専門家による検証と責任を伴った法的リスクジャッジです。

AI時代のリーガルフィーは「仕事が早いほど高い」という料金体系へ


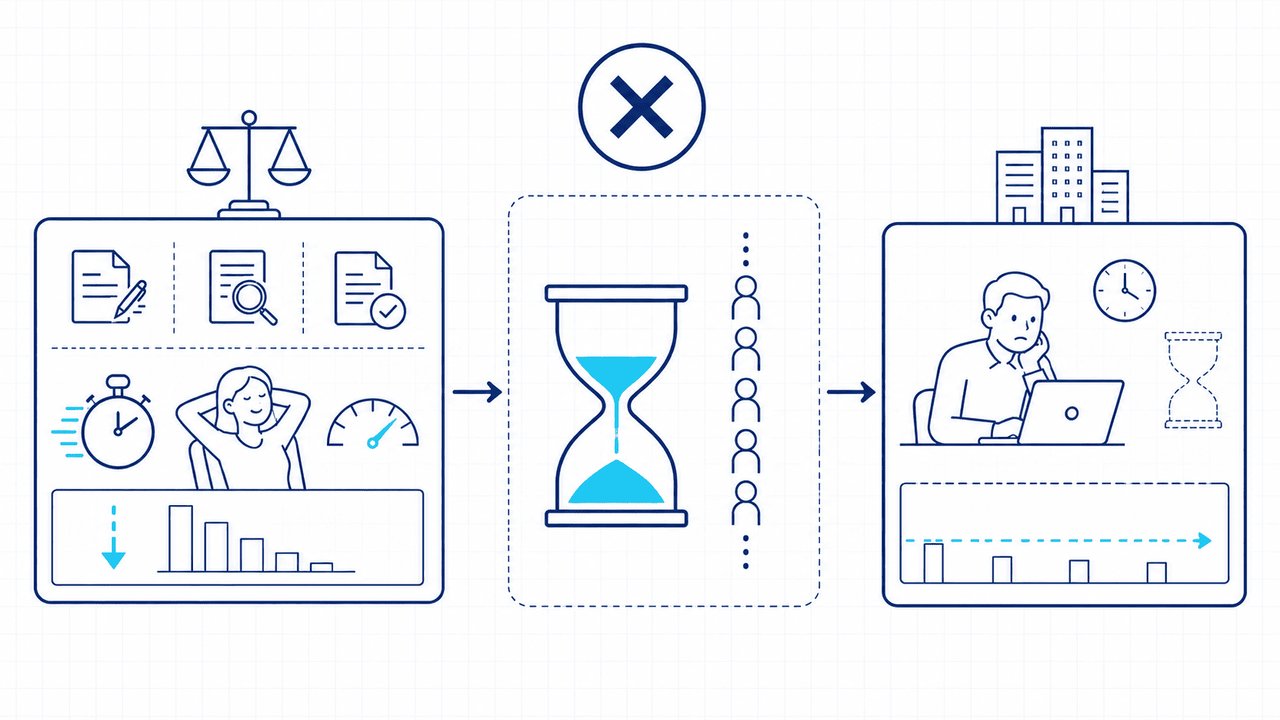
従来のタイムチャージは、法律事務所が時間と人数をかければかけるほど請求額が増える料金体系でした。そのため、AIによって作業が効率化されるほど、売上が減るという矛盾を抱えています。これを定額制に置き換えるだけでは、十分ではありません。定額制は予算を分かりやすくしますが、法律事務所がクライアントの経営判断を早めた価値までは価格に反映できないからです。

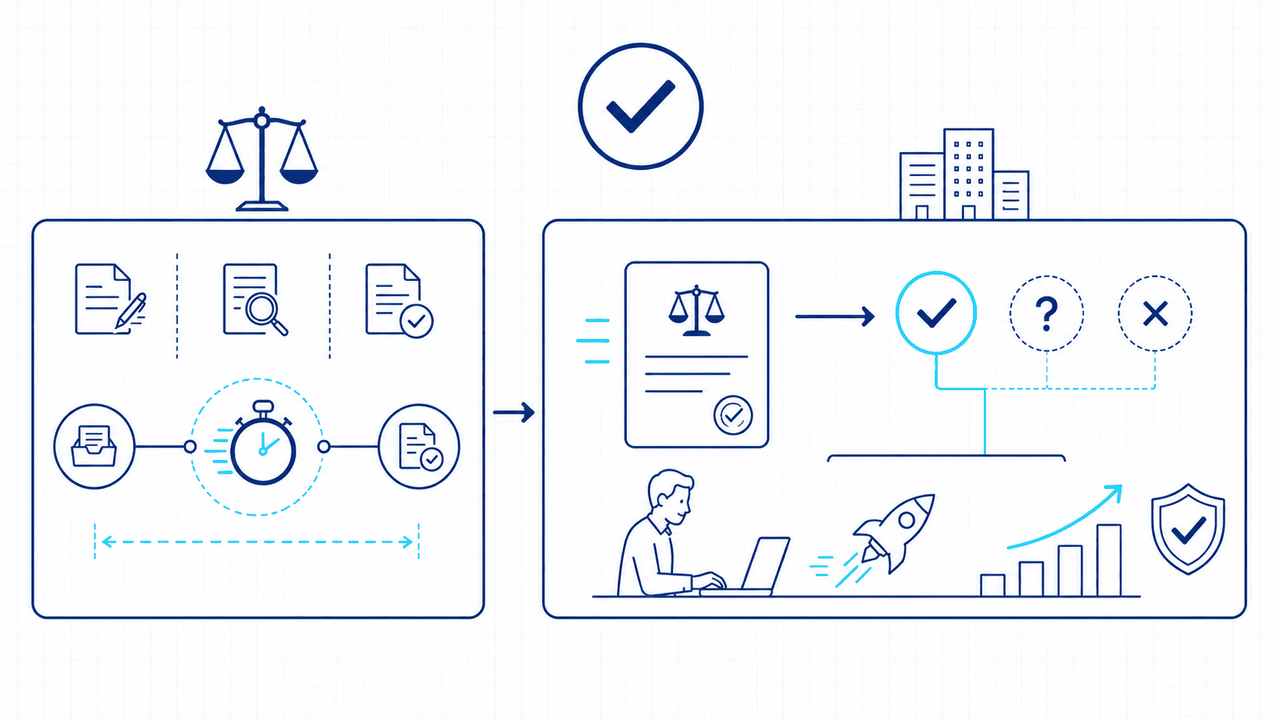
AI時代の法律事務所が売るべきなのは、作業時間の短さそのものではなく、企業内では確定できない高度な法的リスクについて、十分な専門性、根拠、説明可能性を備えた判断を、経営上必要な時点までに提示する能力です。

M&Aの入札期限までに、買収価格へ織り込むべきリスクを確定する。当局への届出前に、許認可取得の障害と現実的な解消策を示す。取締役会の前に、訴訟継続と和解のどちらが企業価値に適うかを判断できる状態を作る。こうした場面では、同じ結論であっても、一週間後に提出される意見書と、明日の経営会議に間に合うリスクジャッジとでは、価値がまったく違います。

もちろん、「早いほど高い」が成立するのは、速さと引き換えに品質を落とさないことが条件です。重要な反対説や不確実性が示され、必要な専門家による検証を経て、経営会議や取締役会で説明できる判断でなければならない。その品質を満たした上で、高度なリスクジャッジを早く提供できる法律事務所ほど、高い料金を請求してよいはずです。

これはタイムチャージと正反対の料金原理です。時間をかけるほど高いのではなく、高度な法的リスクジャッジを早く提供するほど高い。「早く終われば安い」から、「早く決められるほど高い」へ。私たちは時間ではなく、複雑な不確実性を経営が選択可能な判断へ変換する能力に課金していると、正面から説明すればよいのです。

うちに依頼しなければできない判断とは何か、それをどのような品質と速度で提供できるのかを言語化し、その価値に値段を付ける。この料金原理をいち早く具体化し、顧客へ説明できる法律事務所が、AI時代の価格決定権を握ることになるのだと思います。
 

2026.8.6追記

「ふつうの法務部員」様に、クライアント(企業法務)側の立場からの貴重な感想・ご意見をnoteに投稿していただきました。御礼とともにご紹介させていただきます。


法務部が早く帰れたか、ではなく事業部が早く動けたか ―AI導入効果を測る最上位KPIは「法務待ち時間」の解消

法務部門にAIを導入したとき、最上位KPIに置くべきなのは、法務担当者の作業時間削減率ではありません。事業部門が法務の判断を待っていた時間の削減率です。

もう少し厳密に定義すれば、次のようになります。

「法務起因の待ち時間」
=依頼を受けてから、事業部門が「実行する・条件付きで実行する・中止する」という次の行動に移れる状態になるまでに、(案件の種類・難易度・リスクを調整した上での)法務側で案件が滞留していた時間


AIによって「法務の作業が何時間減ったか」ではなく、「事業が法務を待つ時間がどれだけ減ったか」を測るべき、というお話です。

AI導入のKPIを「法務部員が何時間ラクになったか」にしてはいけない


法務へのAI導入効果を説明するとき、多くの会社が

「契約審査時間にかかった時間を30%削減」
「リサーチに要した時間を年間1000時間削減」

といった数字を掲げます。分かりやすい数字ですし、それこそリーガルテック企業が営業・マーケティングに使ってそうなフレーズです。しかし、経営者にとってそのKPI達成が本当に重要か?うれしい報告か?法務部門を評価する気になるか?というと、かなり怪しくないでしょうか。

52D4CF42-AD2A-4E56-95E3-BF8D9464F62A

法務担当者が契約書の初稿を作る時間を60分から20分に短縮しても、その依頼が法務側の受信箱で二日間眠っていたのであれば、事業部門にとっての速度は変わりません。担当者がAIで条文・判例を数秒で検索しても、上席レビュー待ちで3日止まれば、事業担当者も3日待たされます。

反対に、法務担当者の総作業時間がほとんど減っていなくても、依頼を受けた直後に論点を整理し、「A案なら進行可能。B案は追加確認が必要」と暫定判断を返せれば、事業部は顧客・取引先のために次の行動に移ることができます。法務部門の作業時間と、会社としての意思決定時間は、区別して捉える必要がある、ということです。

法務内の作業時間削減を最上位KPIにすると、AI導入の目的が「法務部員を少し暇にすること」へすり替わりがちです。経営者から見れば、その先にあるのは「では、法務の人員を減らしてもいいか」になってしまいます。法務部門が示すべきなのは、自分たちの手間が何時間浮いたかではなく、事業部がどれだけ早く次の行動へ移れたか、であるべきです。

この点に関して、法務部門に居ると、Wordファイルとして出力した文書・レポートが仕事の成果物であるかのような錯覚に陥りがちです。しかし、事業部門が法務に求めているのは、Wordファイルではありません。

・この契約を締結してよいのか
・この広告表現で出してよいのか
・このデータ利用方法で進めてよいのか
・この事業スキームは、どこを直せば実行できるのか

事業部門が欲しいのは、"次のビジネス行動へ移るための判断"です。

法務部門は、法的に完全な文章を製造する工場ではなく、会社が許容可能なリスクの範囲内で、意思決定を止めずに進めるための補助装置である。そこに立ち返れば、目指すべきゴール・目的を履き違えずにすみます。

測るべきは、単純な「回答までの時間」ではなく、「事業部がネクストアクションに移れるまでの法務待ち時間」


もっとも、依頼受付から回答送信までの経過時間を、そのまま測ればよいわけではありません。案件が遅れる原因は、法務だけにあるとは限らないからです。

そこで、計測対象を「法務起因の待ち時間」に限定します。計測開始は、法務が判断に必要な最低限の情報を受け取った時であり、計測終了は、事業部門が「実行」「条件付き実行」「中止」のいずれかを選び、次の行動へ移れる情報が示された時点です。

・依頼内容に必要な事実がない
・事業部門から追加情報が返ってこない
・取引先・相手方の回答を待っている
・経営判断待ちになっている

こうした、法務がコントロールできない時間は除外して計測します。

一方、担当者未割当て、着手待ち、調査中、ドラフト作成中、上席レビュー待ち、回答文面の調整中は、原則として法務起因の待ち時間に含めます。

重要なポイントは、「正式な最終回答を成果物として引き渡した」時点まで待つ必要はないという点です。「現時点ではA案なら進めてよい。B案は追加確認が必要」と返せば、事業部門はA案ので事業準備を始められます。この時点で、少なくともA案について、事業部門の「法務待ち」は解消しています。

AIは、完成した美しいWordの契約書や意見書を早く作るためだけでなく、論点整理と暫定判断を早期に返すために使うべきです。

43BD6852-DD04-413B-9CBA-5FD478F0F413

同じ種類の案件どうしで比べる


法務待ち時間を比較するときは、案件の種類・難易度・リスクをそろえる必要があります。この点は少し工夫が必要です。

NDAと大型業務提携契約、定型広告審査と新規事業の適法性判断を、同じ「1件」としてカウントしスコアリングしても意味はありません。AI導入後に難しい案件が増えただけで、待ち時間が長くなったように見えることもあります。そこで、案件を次の3つの軸で分類します。

1)案件の種類:契約審査/法律相談/広告審査/個人情報の取扱い/紛争など
2)難易度:定型/準定型/非定型
3)リスク:低/中/高

そのうえで、同じ種類・難易度・リスクの案件について、AI導入前と導入後を比べます。

見るべき数字も、全案件の単純な平均だけではなく、一部の極端に長い案件に引っ張られないよう、典型的な案件では何時間かかっているかを中央値で見る。「24時間以内に判断を返せた案件が何%あったか」のように、一定時間内に処理できた割合も確認する。そのようにして、

「低リスクの定型契約について、法務待ち時間の中央値を18時間から4時間へ短縮した」
「中リスクの準定型案件について、24時間以内に条件付き実行の判断を返せた割合を35%から70%へ改善した」

と示せる状態を作れば、AI導入が事業速度に与えた効果を具体的に説明できます。

スピードが速ければ何でもよいわけではない、という批判もありそうです。そこが気になるようであれば、重大修正率、事実誤認、重要条項の欠落、上席レビューで結論が覆った割合などを確認し、品質が悪化していないことを条件に加えて計測できればなお良しです。

会社が法務待ちによって、何時間を失わずに済んだか?―法務部門が測定すべきAI導入効果測定のKPI


以上をまとめると、KPIの構造は、次の三層が考慮されていれば十分だといえます。

・最上位KPI:法務起因の待ち時間
・制約条件:重大な品質劣化が起きていないこと
・補助指標:人的投入時間、処理件数、AI利用率、セルフサービス完結率

最上位KPIをクリアに置くと、AIの使い方も変わります。依頼受付時に不足情報を洗い出す。案件をリスク分類して即時に担当者へ割り振る。定型案件はセルフサービスで完結させる。非定型案件はAIが論点を先に抽出する。上席レビューが必要な部分を特定し確実にエスカレーションする。最終回答前でも、事業を動かせる暫定判断を返す。

測るべきなのは、法務部員がAIで何時間得をしたかではない。そうした問題意識を持って、KPIを「法務起因の待ち時間」と置いた瞬間、法務へのAI導入は、単なる業務効率化ではなく、会社の意思決定速度を改善する経営プロジェクトへと昇華します。
 

高度専門職がAIを使いこなすのに必要なのは「帰納と演繹のスイッチ」

AIの利用を咎められるのは、「使ったこと」自体ではなく「検証しなかったこと」


法務でAIを使おうとすると、必ず最初に立ちはだかるのがハルシネーションの問題です。もっともらしい顔で、実在しない条文や判例を差し出してくる。これが怖い、というのは、誰もが口にする「AIを使わない理由」の筆頭になっています。

そして皮肉なことに、この落とし穴に最も深くはまっていることでやり玉に挙げられるのが、本来なら出典の正確性に一番うるさいはずの専門家、プロの弁護士たちです。ChatGPTが作った架空の判例を裁判所に提出して制裁を受けた、という話は、もはや珍しくもなくなりました。

▼ChatGPTで"存在しない判例"を引用 米国の弁護士に制裁、出禁や罰金(ITmedia AI+)
米国カンザス連邦地方裁判所は2月2日、生成AIが作り出した架空の判例や虚偽の引用を含む準備書面を提出した原告側弁護士5人に対し、連邦民事訴訟規則第11条に基づく制裁を科す決定を下した。(中略)調査の結果、原告側弁護士がChatGPTを使用して判例調査を行い、その結果を検証することなく書面に挿入していたことが判明した。書面には存在しない判例への引用、実在する判例からの架空の引用文、判例の内容を誤って伝える記述など、11項目にわたる重大な誤りが含まれていた。

この事件でひとつ押さえておきたいのは、裁判所によって咎められたのは、AIを使ったことではなく、AIの出力を人間が検証しなかったことだった点です。

では、その検証という場面において、「人間側が果たすべき仕事」とは、具体的に何なのでしょうか?「ちゃんと確認しましょう」で済むなら苦労はありません。問題は、なぜ確認が必要なのか、そして人間のどんな能力がAIの穴を埋めるのか、という点にあります。ここを詰めないまま「最後は人間がチェックすればいい」と言うのは、実は何も言っていないに等しいからです。

この記事では、その役割分担について私なりに考えてみたいと思います。

inductionvsdeduction-1

専門領域の"それらしい嘘"ほど見破りにくい理由


そもそも、なぜ生成AIのハルシネーションは、法律や医療のような高度専門領域で深刻な問題になるのでしょうか。その根っこにあるのは、いまの生成AI(大規模言語モデル、LLM)の思考の仕組みそのものです。

生成AIが普及していまや多くの人に知られているとおり、LLMは「これまで大量に読んだ文章の並びから、次に来る確率がいちばん高い言葉」を選び続けることで文章を作る装置に過ぎません。過去の膨大な事例から「だいたいこうなることが多い」というパターンを抽出して答えを組み立てる。これは論理学でいう帰納的推論(インダクション)、つまり個別の観察を積み上げて一般的な傾向を導く思考のやり方に、きわめて近いものです。

帰納は強力です。一般的な翻訳・要約はもちろん、契約書のドラフト作成といった専門的な仕事を含め、相場観の要る仕事の大半で圧倒的な戦力になります。ところが、帰納には構造的な弱点があります。「それらしさ」は保証できても、「正しさ」は保証できない点です。判例の引用でいえば、「この論点なら、こういう名前で、こういう判旨の判例がありそうだ」という"相場"に合った文字列を、実在の有無とは無関係に生成してしまうことがあります。

ここで正確を期しておくと、専門領域でハルシネーションが「起こりやすい」かどうかは、実は問題の本質ではありません。本当の問題は次の二点です。第一に、専門領域ほど独特の言い回しや引用形式がかっちり決まっているぶん、相場に合わせて作られた"それらしい嘘"は精巧になり、かえって見破りにくくなる点。第二に、法務や医療では一つの誤りが訴訟や健康被害に直結するため、間違いのコストが桁違いに大きい点です。

もう一つ、技術的な留保も入れておきます。「LLMは帰納しかできず、演繹はまったくできない」と断言するのは、正確ではありません。LLMは演繹"らしき"手順を踏むこともできますし、近年の推論特化型モデルは、答える前に思考のステップを展開することで論理課題の正答率をかなり引き上げています。ただし、それはあくまでトークン予測という統計的な土台の上で演繹的な振る舞いを模倣しているのであって、出力が論理的に筋が通っていることを、仕組みとして保証する機構は内蔵されていないのです。

実際、LLMの推論能力を帰納と演繹に厳密に切り分けて検証した研究は、LLMが帰納にはめっぽう強い一方、演繹には相対的に弱く、とりわけ前提が通常の慣行から外れる「反実仮想的」な設定では大きく崩れることを報告しています(詳細は後述)。矛盾した文章も、存在しない判例も、確率的にありそうであれば自信満々に出力してしまいます。

「最後は人間がチェックすればいい」で済まない事情


「だから最後は人間がチェックすることが重要だ」。そう考えたくなりますし、現にある種の呪文かおまじないのように繰り返し言われている言葉があります。いわゆる Human in the Loop(HITL)です。

けれども、HITLに頼りきることの危うさは、このブログでも何度か書いてきました。人間を一枚かませても、その人間がAIの出力に引きずられてしまえば、安全弁にはなりません。有名なのは放射線科医を対象にした実験で、AIが誤った読影候補を提示すると、経験の浅い読影者ほど大きく引きずられ、そしてベテランですらこの影響から自由ではありませんでした(Dratsch et al., Radiology, 2023)。「人が最後のボタンを押す」ことは、「その判断がAIから独立している」ことを意味しないのです。これは自動化バイアスと呼ばれる、かなり手強い現象です。

そこで問いを少し変えてみます。HITLを「人を挟むこと」ではなく「AIにできないことを人がやること」だと捉え直したら、その"人にしかできないこと"の中身は何なのでしょうか。

その一つであり重要な役割を担うものが、演繹的推論(ディダクション)です。帰納が「個別の事例から一般則を推し量る」思考なら、演繹は「一般則という大前提から、目の前の個別事案に当てはめて結論を導く」思考です。

「法とはこういう原則である」「わが社の行動基準はこうである」という大前提を先に立て、そこから論理を降ろしてきて、「この結論は原理に照らして本当に正しいか」を検証する。相場に合っているかどうかではなく、筋が通っているかどうか。統計的予測を土台とするAIが、その仕組み上もっとも保証できず、対して人間が意識的に切り替えて使える思考であると言えます。

AIに任せる帰納、人間が受け持つ演繹


人間の強みは、演繹ができること自体ではありません。帰納と演繹を、状況に応じて行き来できることです。法務の仕事に引き寄せると、この使い分けはたとえばこんな役割分担になるでしょう。

帰納が活きる場面:過去の類似契約から標準的な条項の型を引き出す。大量のNDAをさばきながら「これは相場から外れている」という当たりをつける。判例の傾向から「この手の事案はこう転ぶことが多い」と見通しを立てる。これらはAIが猛烈に得意で、人間もふだんは半ば無意識に帰納で処理しています。相場観の世界です。

演繹が活きる場面:目の前の一条項について、「なぜこの条項が要るのか」を条文や立法趣旨という大前提から説明する。相場では"普通"とされる落としどころが、自社ならではの不文律やまだ公開されていない今後の経営ビジョンに照らすとのめない、という食い違いを見抜く。前例のない取引スキームを、既存の法原則に当てはめて「この構成なら通る/通らない」を組み立てる。これらは、過去データの相場観だけでは決して答えの出ない世界です。

AIに一次ドラフトと相場観の提示(帰納)を任せ、人間はその出力を原則に当てはめて検証する(演繹)。冒頭のカンザスの事件を、この枠組みで見直してみましょう。

裁判所が要求した「検証」には二段階に分けられます。一つめの「判例が実在すること」。これはデータベースを引けば済む機械的な照合作業です。ここだけなら、検索ツールを噛ませたAIにも代替できるでしょう。しかし二つめの「その判例が引用された命題を支持していること」の確認は、性質がまったく違います。判例が立てた規範という一般則を読み取り、目の前の主張に当てはまるかどうかを吟味する。これは小さな法律意見書を一本書くのに等しい、純然たる演繹の仕事です。

カンザスの弁護士たちがサボったのは、単なる裏取りではなく、この当てはめの工程だった。だからこそ裁判所は、それを委任不能な弁護士本人の義務だと言ったのだと、私は理解しています。

似たような見立ては、AI研究の世界にもあった


こうした「帰納のAIを、演繹の人間が補う」という発想は、私の思いつきではなく、AI研究の論文でも近い形で論じられています。詳細は末尾の参考文献に譲り、ここでは要点だけ引用します。

LLMの推論能力を帰納と演繹に切り分けて検証した研究(Cheng et al. 2024)は、そもそもこの二つが混同されてきたと指摘したうえで、こう問いを立てています。

Despite extensive research into the reasoning capabilities of Large Language Models (LLMs), most studies have failed to rigorously differentiate between inductive and deductive reasoning... In LLM reasoning, which poses a greater challenge - deductive or inductive reasoning?

「LLMの推論において、演繹と帰納のどちらがより難関なのか」。この問い自体が、両者を別物として設計する必要があることを示しています。そして検証の結果は明快でした。純粋な帰納タスクを切り出すと、LLMはほぼ満点に近い性能を叩き出す。一方で演繹は相対的に弱く、とりわけ前提が通常の慣行から外れる「反実仮想」の設定で顕著に崩れると述べます。

これは法務パーソンにとって聞き捨てならない結果です。「世間の相場どおりの前提」なら型どおりに当てはめられるが、「自社だけの特殊な前提」を置いた瞬間に、AIは慣れ親しんだ相場のパターンへと引き戻されてしまう。そして法務の実務で本当に演繹が必要になるのは、まさにその「相場から外れた前提」の場面なのです。

では、AIに演繹をさせる工夫はないのか?帰納と演繹を段階的に組み合わせるプロンプト設計(De-In-Ductive法)を提案した研究(Cai et al. 2024)は、この工夫で正答率が一貫して向上することを示しました。ただし同じ論文は、それでも単純な論理パズルすら100%には届かない理由を、トークン予測という土台が「厳密な論理的一貫性を要求されるタスクには本質的に不向き」だからだと率直に認めています。そしてもう一つ、この論文には見逃せない一節があります。人間は帰納で仮説を立て、演繹でそれを検証するというモードの切り替えを動的に行えるのに対し、現在のLLMにはこの切り替えの柔軟性が欠けている、という指摘です。

法務AIの領域では、規則ベース(演繹)・判例ベース(帰納)・仮説形成(アブダクション)の推論を統合する枠組みが提案されています(Nguyen et al. 2025)。統計的なLLMの出力に、構造化された法的推論の検証層を重ねて、誤った条文適用をふるい落とす。まさに「帰納の出力を演繹で裏打ちする」発想の工学的な実装例です。

そして人間とAIの協働そのものを扱った研究(Hemmer et al. 2024)は、人間とAIのチームが単独をしのぐ「補完的チーム性能」の源泉を、能力の非対称性(互いに違うことが得意)と情報の非対称性(互いに違うものが見えている)に求めています。生成AIの弱点が統計的予測ゆえの論理的保証の欠如で、人間の強みが演繹的な当てはめと価値判断であるなら、これはまさに能力の非対称性が成立する典型例です。ただし同じ研究は、冷や水も浴びせています。この補完的チーム性能は、理屈のうえでは成立するはずなのに、実証研究ではめったに観測されていないというのです。

人間がAIに引きずられて独自の判断を手放してしまう、つまり自動化バイアスが働くと、非対称性は紙の上の話に終わる。私がこのブログで何度も述べてきたHITLの欠点の話に戻ってくるわけです。

私たちは何をきっかけに演繹に切り替えているのか


ここまでで、勘のいい読者のみなさんなら、一つの疑問に行き当たっているはずです。人間が帰納と演繹を使い分けられるとして、私たちは普段、いったい何をきっかけに、そのスイッチを切り替えているのでしょうか?

自分の仕事を振り返って、私なりに答えを言葉にすると、切り替えのトリガーは三つあるように思います。

一つめは、違和感です。過去の相場観(帰納)で案件を処理しているときに、ふと「なんか変だ」という信号が立つ瞬間。この条項だけ妙に一方的だ、この金額はさすがに桁が一つ多くないか、この相手はなぜここだけ強硬なのか。面白いのは、この違和感そのものが、大量の事例を積み上げてきた帰納の産物だという点です。相場を知っているからこそ、相場外れに気づける。帰納が、演繹を起動させる引き金になっているのです。「統計的な外れ値検知ならAIにもできるのでは」と思われるかもしれません。確かに、別の仕組みを外付けすれば近いことはできます。しかし、文章を生成している当のモデル自身は、自分の出力を独立の基準で監査できません。同じ相場観の中で自己点検をしても、相場ごと間違っているときには何も検知できない。だから、相場から外れた出力も、平然と、むしろ自信満々に差し出してくる。自分の「変だ」を自分で発火させられないから、暴走にブレーキがかからないのです。

二つめは、不可逆性です。「これは間違えたら取り返しがつかない」と感じた瞬間、人は相場観のモードから、原理原則にさかのぼって一つずつ確かめるモードへ切り替えます。捺印の直前、開示するかどうかの判断、撤退の可否。人間の違和感が単なる異常検知と違うのは、それが「これを自分の責任で通してよいのか」という利害と結びついた信号だからです。重さを感じ取ったときに、演繹のギアが入る。

三つめは、説明責任を果たすための「なぜ?」という自問自答の習慣です。相場感だけでは「普通はこうします」で通してしまう。ところが「それはこのケースにおいても妥当するか、なぜそうなのか、根拠は何か」と不断に問う習慣によって、条文や立法趣旨という大前提までさかのぼらざるをえなくなる。説明責任が、演繹を強制するのです。

そう考えると、法務パーソンの仕事の質は、このスイッチをどれだけ的確に、遅れずに押せるかにかかっているとも言えます。そしてAIの本当の弱点も、ここで輪郭があらわになります。先ほどの研究が指摘していたとおり、AIに欠けているのは演繹の"真似"をする能力ではなく、いつ演繹へ切り替えるべきかを自分で判断するトリガーのほうなのです。違和感も、不可逆性の感覚も、説明責任の重みも、AIの側からは発火しない。だからこそ、人を一枚挟んでも、その人が相場観のまま(自動化バイアスのまま)流してしまえば、切り替えは起きず、カンザスの事件のように架空の判例がすり抜けていくのです。

スイッチを意識的に切り替える


いまの生成AIは、統計的・帰納的な予測を土台とする、きわめて優秀な相場観の装置です。だからこそ、それらしい嘘をつく。そしてその嘘は、人間が演繹に切り替えて、大前提に当てはめて検証したときにだけ、はじめて暴かれます。

Human in the Loop は、ただ人を挟むことではありません。挟まれた人間が、相場観の帰納モードから演繹モードへ、意識的にスイッチを切り替えること。そこまでやって、ようやく安全弁になります。違和感を捉え、不可逆性を感じ取り、「なぜ」に立ち返る。その引き金を、自分の意志で引けるかどうか。

AIを脅威だと感じる人と、武器として使いこなす人。両者を分けるのは、AIの知識量でも、プロンプトの巧みさでもありません。AIが決して持てない"切り替えのスイッチ"を、自分の手の中に握っていると自覚し、それを意識的に、上手に押せる人。それが、これからの法務でAIを味方につけられる人の条件だと考えます。

その意味で、私たちがまず鍛えるべきなのは、AIの使い方ではなく、自分がいまどちらのモードで考えているのかを、いつでも自問できる感度のほうなのだと思います。

参考文献

すべての会社に必要なはずのCLM(契約管理ツール)が売れない理由──合意文書は「不動文字」ではいられない

ある有識者からの問いかけ


前回のブログ「AIガバナンスの正体は、人ではなく文書である──AISIのCAIOガイドが示した "Document in the Loop"」を公開したところ、ある尊敬する有識者から丁寧なメールをいただきました。

その方は、デジタル社会における法的手続の信頼性について研究を進めておられ、紙の書面が担ってきた信頼の構造を「本人性」「真正性」「信頼性」「真意性」という四つの要素に分解して整理されています。そのうえで、私の Document in the Loop は四要素のうち「信頼性(検証・監査可能性)」の再構築に相当するのではないか、という位置づけをしてくださいました。

そして同時に、私に対して次の問いを突きつけられた気がしました。

紙の書面が暗黙のうちに束ねてきた本人の関与、成立の真正、改変防止、熟慮を通じた真意の確保は、デジタル化によってバラバラに分解される。Document in the Loop は、そのうちの一つ(信頼性)を明示的に再構築する試みとしては正しい。しかし、残りの要素、とりわけ「真意性」はどう担保するのか?

実は、このことは別途ブログで書こうと思っていたテーマでしたので、その方への返信に代えてこの記事を書きたいと思います。

なぜCLMは売れないのか


唐突に聞こえるかもしれませんが、ここでCLM(Contract Lifecycle Management=契約ライフサイクル管理)ツールの話をさせてください。

CLMとは、契約書のドラフト作成、レビュー、承認フロー、締結、更新管理、期限管理、権限管理、監査対応までを一元的に管理するツールのことです。AIガバナンスにひきつければ、契約という「文書」をデータとして、会社で行われる仕事のループの中に置き続けるためのインフラです。

理屈の上では、すべての会社にCLMが必要なように見えます。契約書が紙のまま、あるいはPDFのままフォルダに埋もれていれば、契約をした事実が後任者に引き継がれず、支払期限を見落とし、責任上限等契約条件の変更を追跡できず、監査にも耐えられなさそうです。

ところが、現実のビジネスの世界では、CLMはまったくと言っていいほど売れないのです。

正確を期せば、グローバルな大企業や大手法律事務所では導入が進んでいて、外国では一部製品が寡占的な地位を占めています。ただ、ビジネス市場全体で見れば、CLMの普及率はお世辞にも高いとは言えない。リーガルテックの中で最も必要性が明白そうな製品が、ほとんど売れていない。これはなぜでしょうか。

free-from-written-in-stone-text-1

法務パーソンの本能的気づき「契約書をデータベース化してもすぐに陳腐化する」


CLMベンダーの営業は、その導入メリットをこう語ります。

「紙契約・電子契約にかかわらず横断的に検索可能になります」
「期限アラートを自動化できます」
「条項の傾向分析ができます」
「監査証跡が残ります」

どれも正しく、契約書管理の理想の姿に見えます。しかし、多くの法務部門は「なるほど、便利になりますね」と言いながら、現実には導入しません。なぜでしょうか?

私なりにこの理想と現実のギャップについて考えると、こういうことではないかと思うのです。契約書に書かれた「合意」は、締結した翌日からビジネスの現実と乖離し始める。取引先との力関係が変わる。市場環境が変わる。担当者が替わる。書面に書かれた条項はそのままでも、当事者の内心──つまり「真意」──は日々動いていく。

契約書は締結した瞬間から形骸化する、とまでは言いませんが、「いま手元にある契約書の文言が、当事者双方のいま現在の真意や内心を正確に反映しているか」と問われれば、相当数の契約書について、答えはNoでしょう。

このことを、お客様の多くは言語化まではできていないまでも、本能的には気づいている。だから、多額の費用をかけて契約書をデータベース化することに、価値を感じない、そのデータの現在価値が薄い以上、将来に向けた投資に見合わないと感じているのです。

CLMが売れない最大の理由は、UIの出来でも価格でもなく、「契約書の不動文字をカネをかけてデータベース化したところで、そのデータとしてのビジネス上の価値はすぐに陳腐化してしまう」という、身も蓋もない事実にあるのではないでしょうか。

「真意性」は締結の瞬間だけの話ではない


ここで、冒頭の有識者が提示した四要素のうちの1つである「真意性」に話を戻します。

その方は、紙の世界では対面での説明、署名押印までの時間、紙面を読む行為が、内容理解や熟慮の機会を一定程度組み込んでおり、意思形成に必要な説明・理解・熟慮の機会が確保されやすかった、と整理されています。これはまさにその通りで、デジタル化が進むほどに「クリック1回で完了する」プロセスとの対比で、紙の持っていた機能の大きさが際立ちます。

たしかに、締結時に真意を確保することの重要性は疑いようがありません。しかし、ビジネスの現場で契約書・覚書・社内規程といった合意文書に日々触れている法務の感覚からすると、真意性の問題はそこで終わらないのではないか、と思うのです。

契約は締結された翌日から、ビジネスの現実とともに動き始めます。昨日は完全な合意だったものが、今日のビジネス環境の変化で、当事者の一方にとっては不本意なものに変わっている。今年のはじめには契約当事者双方想像もしなかった武力行使を伴う紛争が今月になって発生したことで、来月には契約したビジネスの前提条件そのものが無くなってしまっているかもしれない。これは当事者の不誠実ではなく、ビジネスの自然な動態です。

このように、真意性という概念を、締結の瞬間だけでなく中長期的な時間軸の中で捉え直すと、前述したCLMが売れない理由ともつながってきます。締結時点の合意を静的に保存するだけでは、データベースの中身はどうしても「過去の合意の記録」にとどまる。だから、投資に見合う価値を感じにくいのではないでしょうか。

Document in the Loop の「Document」は不動文字ではない


私は前回のブログで、「AIガバナンスの正体は人ではなく文書である」と書きました。この主張は撤回しませんが、そこで述べた「文書/Document」は、一度書いて確定したら動かさない不動文字を前提としていません。

紙のパラダイムに囚われていた従来の文書観では、文書は完成品そのものでした。署名押印された契約書、承認済みの稟議書、確定版の議事録。それらは「固定された最終形」として保管され、参照されてきた。この文書観の上では、文書をデータベース化するCLMは「過去の完成品のアーカイブ」にしかなりません。

しかし、デジタル時代の文書/Documentは、本来もっと可変的なものとして扱える・扱うべきだと考えます。

たとえば、こういう世界観です。昨日締結した契約について、当事者の一方が「価格条件について再協議したい」と感じ始めた。その気持ちの変化を、今日になって契約管理システムに書き足す。相手方にも共有される。双方の現在の認識がリアルタイムに可視化され、正式な変更合意に至ればバージョンが更新される。至らなくても、「この時点でこの条項について認識の乖離が生じていた」という事実が証跡として残る。

翻って見れば、ソフトウェア開発の世界ではすでに当たり前のことです。仕様書はGitで変更履歴が管理され、イシューやプルリクエストで合意形成のプロセスがすべて残る。仕様の「真意」が変わったら、変わったことがコミットログに刻まれる。文書は「完成品」ではなく「プロセスの現在地」として機能しています。

前回紹介したAISIのCAIOガイドブック自身が、まさにそのことについてこう書いています。

「なお本ガイドブックは、AI 技術動向、事業環境、関連法令・ガイドラインの改定等を踏まえて随時更新される「Living Document」として運用されるべきである。」(『Chief AI Officer ガイドブック』3頁)

ガバナンス文書そのものが不動文字であってはならないというのは、前回ご紹介したAISI自身の立場でもあるわけです。

すべての合意文書は、リビングドキュメントになっていく


この発想を押し広げると、こうなります。

ビジョン、規律、ルール、契約、合意…こうした文書は、すべてリビングドキュメントとして扱われるべきです。一度書いて終わりではなく、状況の変化に応じて書き足され、改訂され、その変遷をすべて証跡として残さなければならない。

だからこそ、すべてを電子化・デジタル化する必要がある。

紙の文書をリビングドキュメントとして運用するのは、物理的にほぼ不可能です。改訂のたびに印刷し直し、旧版を回収し、関係者に再配布し、どの版が最新かを台帳で管理する。これでは社会は回りません。日々変わる状況に合わせてスピーディに改変し、その証跡を残すには、デジタルであることが前提条件です。

free-from-written-in-stone-text-2

ここに、CLMが本来進むべき方向も見えてきます。CLMが売れないのは、CLMという製品カテゴリが不要だからではありません。既存のCLMが「過去の完成品のアーカイブ」という静的な文書観の上に乗っているからです。もしCLMが、契約を「締結して終わり」の固定文書ではなく、当事者間の合意の現在地をリアルタイムに反映するリビングドキュメントとして扱うようになったら、その価値は一変するはずです。

Document in the Loop の本当の意味


Document in the Loop とは、固定された完成品の文書をファイリングして保管することではありません。文書が生きたまま輪の中にあり続けること、つまり、組織の現在の意思と判断と状況を反映し続け、変化があればその変化自体が証跡として刻まれ、いつでも現在地と過去の経緯の両方を遡れる状態のことです。

信頼や確かな判断のベースとして文書をループの中心に置きつつも、そこに書かれた内容や真意が永遠に変わらないという前提には立たない。

冒頭の有識者が指摘した「真意性」の問題に対する、私なりの回答はこうです。真意性は、締結時に一度だけ確保して終わるものではない。当事者の真意は動き続ける。だからこそ、文書もまた動き続けなければならない。そして、その動き続ける文書のすべてのバージョンと変遷が検証可能な形で残ること、それが、Document in the Loopの本当の意味です。

文書がまだ紙であった時代には、「確定した過去」を保存すれば十分でした。しかし、これだけ不確実性が高まった現代において、文書は、デジタルの力を借りて「変化し続ける現在」を記録するものになるべきです。その移行ができて初めて、AIガバナンスも、契約管理も、そして登記やその他の法的手続も、社会の中で新しい信頼の基盤となるのだろうと思います。
 

無料版Claudeに機密情報を入れた男の末路── Heppner事件の意義と、AI利用規約を読み解く前提となる4つの「箱」

米国には「秘匿特権(attorney-client privilege)」という法理があります。これは、会社や個人が法的な助言を受けるために弁護士と秘密にやり取りした内容について、裁判や公的調査で相手方や政府から「その中身を出せ」と求められても、原則として開示を拒めるというルール。依頼者が弁護士に不利な事実も含めて率直に伝え、適切な助言を受けられるようにするための仕組みです。

日本では米国ほど広く一律に開示を拒める制度がないこともあって、なじみの薄い概念かもしれません。しかし、2026年2月に米国で発生している秘匿特権を争う裁判が、AI時代のガバナンスを考える法務パーソンに刺さる問いを突きつけました。

「AIに入力した情報は、誰のものか」
「その情報の秘密は、どこまでが守られ、どこで失われるのか」

この問いは、秘匿特権のある米国だけの話ではありません。自社の機密情報をAIサービスに渡すとき、その情報がどう扱われるかは、日本企業にとっても同じく切実な問題です。

何も確認せずにAIに機密情報を入れたら、秘匿特権は吹き飛ぶ


United States v. Heppner事件(1:25-cr-00503-JSR, SDNY 2026)は、ニューヨーク南部地区連邦地方裁判所のジェド・ラコフ判事による、生成AIと秘匿特権に関する全米初の判断です(Akin Gumpが公判前決定のメモランダムPDFを含む解説を公開しています)。

ai-heppner-4


証券詐欺等の容疑で逮捕されたHeppnerは、弁護人を選任した後、消費者向け無料版のClaudeを使い、自ら防御戦略の分析レポートを作成していました。さて、これが弁護士への相談であれば、国や相手方から「その中身を出せ」と言われても、秘匿特権によって一定の範囲で相談の秘密を守れるはずなのですが、無料版のClaudeに読み込ませた文書にそれは認められるのでしょうか。

Paul, Weissの解説がわかりやすいので一読をお勧めしますが、結論として、ラコフ判事は秘匿特権の適用を否定しました。

ここで注意すべきは、裁判所が何を根拠に判断したかです。本件でラコフ判事が評価したポイントは、AIの裏側を支える技術的なアーキテクチャではありません。見たのは以下の3点です。
  • Anthropic社のプライバシーポリシーに、ユーザーの入力データをモデルの学習に使用すると明記されていたこと
  • 同ポリシーに、政府規制当局を含む第三者へのデータ開示の権利が留保されていたこと
  • 被告が自発的に第三者のプラットフォームに情報を開示しており、通信における「合理的な機密性の期待」が存在しなかったこと

つまり、せっかくの秘匿特権を吹き飛ばしたのは、利用規約・プライバシーポリシーの中身と、第三者への自発的開示に等しい行為が事実として認定されたためです。

ai-heppner-3

しかし、この事件を取り上げて「ほら見ろ、だからAIを使わせるのは危険だ」で終わらせるのは早計です。

注目すべきは、ラコフ判事がわざわざ付言した部分です。Gibson Dunnの解説でも強調されていますが、データの機密性が担保されたエンタープライズ版AIを、弁護士の指示の下で利用していた場合には、結論が異なり得たと示唆しています。

さらに本件では、Kovel doctrine(弁護士の秘匿特権を業務上の非弁護士専門家にも拡張する法理)の適用可能性にまで言及しています。つまりこの公判前決定は、AIの利用環境を正しく選べば秘匿特権が維持される道筋を、反対解釈によって同時に示してもいるのです。

裁判官が見たのは「規約」、ではなぜ「技術」を知る必要があるのか


今回の公判前決定の射程を正確に言えば、裁判所はAIサービスの技術的な構造そのものには踏み込んでいません。評価したのはあくまで、利用規約・プライバシーポリシーの文言から導かれる「機密性の期待の有無」です。

では、法務パーソンは利用規約さえ読めればいいのか。私はそうは思いません。なぜかといえば、利用規約・プライバシーポリシーに何が書かれるか、どこに気を付けてチェックすればいいかは、サービスの技術的な設計と強く連動しているからです。

AIツールの利用環境は、データの所在と管理主体によって大きく4つに分けられます。
  • ローカル ── AIモデルを自分のPC上で直接動かす方式。データは外部に一切出ない。機密性は最も高いが、現時点では最先端モデルと同等の性能を得るのは難しい。
  • オンプレミス ── 自社サーバーにAIモデルを設置して動かす方式。データは社内ネットワークの中に留まる。銀行や製薬会社など、高度な規制産業で採用されるパターン。
  • シングルテナント・クラウド ── クラウド上に自社専用の環境を構築する方式。原則として他社のデータとは物理的・論理的に分離されており、モデル訓練にもユーザーデータは使われないことが一般的。Claude Enterpriseや各クラウドプロバイダー上でのプライベートデプロイがこれに近い。
  • マルチテナント・クラウド ── claude.aiの無料版やChatGPTの無料版がこれ。多数のユーザーが同じインフラを共有し、利用規約次第でデータがモデル訓練に使われ得る。Heppner事件で問題になったのは、この環境。

これらはSaaS・クラウドサービスのリスク分析でもよく見た分類です。違いはといえば、クラウド時代を迎えて死語になりつつあった「ローカル」がここへ来て復権したことでしょうか。これは、AIエージェントに扱わせる情報を物理的に隔離する必要がでてきたためです。

この4分類と利用規約の関係はこうです。一般的に、ローカルやオンプレミスでは「訓練利用」や「第三者開示」の条項はそもそも問題になりにくい。また、シングルテナント・クラウドでは、規約上も訓練利用を排除する設計が一般的です。しかし、マルチテナントの消費者向けサービスでは、訓練利用と第三者開示の留保がデフォルトで規約に組み込まれていることが多い。Heppner事件のClaudeの無料版も、まさにこのパターンでした。

ai-heppner-1

注意したいのは、この対応関係は「一般的にそうなりやすい」という傾向であって、技術構造が直接に法的結論を決めるわけではないという点です。

セキュリティ的に望ましいとされるシングルテナントであっても、規約に訓練利用・第三者開示の留保・ベンダー技術者による監視(目視)権があれば秘匿特権の維持は危うくなり得ます。逆に、マルチテナントでも規約で機密性を保証する設計は理論的にはあり得る。最終的に裁判所が見るのはあくまで規約と運用の実態です。しかし、技術構造を知らなければ、目の前の規約の条項がなぜそう書かれているかの背景が読みとれません。

規約の文言を「点」で読むのではなく、技術的な仕組みという「面」で理解するために、この4つの箱を頭に入れておく意味があります。

AIエージェントレイヤーの掛け算によって複雑化するリスク判断


会社がSaaS・クラウドを使うとき、自社データがどこに置かれ、誰がアクセスでき、どう管理されるかを確認するのは、法務にとって今さら珍しいことではないはずです。

ところが、AI時代を迎え、クラウド時代のセキュリティ知識だけでは済まないもう一つのリスク要因が掛け算で加わってきます。エージェント技術です。

以前の記事でも書いたとおり、Claude CodeやCoworkのようなAIエージェントは、指定されたフォルダの中でファイルを読み書きし、コマンドを実行し、ブラウザを操作するところまで自律的にやります。なんならファイルを削除することすらします。つまり、データがどこに保管されるかという「箱」の問題に加えて、その箱の中でAIが何をどこまで操作できるかという「手足の自由度」の問題が上乗せされるのです。

もし、クラウドのアーキテクチャすら正確に理解できていない状態で、さらにAIエージェントの権限設計まで判断しなければならないとすれば、大きなリスクを見誤る可能性があります。これが、AI時代の法務パーソンが直面しているリアルな難易度です。

ai-heppner-2

「AI利用の全面禁止」は法務の役割放棄


Heppner事件で秘匿特権が否定されたのは、一見すると「無料AIなんて使っちゃうからだよ」で片づけられてしまいがちですが、そうではなく、利用規約を確認せずに、訓練利用と第三者開示の留保があるサービスに機密情報を入力したからです。

この区別がつかないまま「AI導入は法的・セキュリティリスクだ」と叫んでも、出てくる結論は「AI全面禁止」の一択にしかなりません。それは法的助言ではなく、恐怖に駆られて反射的に踏んだブレーキでしかありません。

以前の記事で書いたとおり、AIガバナンスの実体は「情報アクセス(ディレクトリ/フォルダ)のパーミッション設定」に帰着します。どこにあるファイルをAIに開放するか、読み取りだけか書き込みも許すかという設計判断。Heppner事件は、その延長線上にある話です。フォルダ権限が物理的なアクセス範囲の制御なら、利用規約の理解は法的なアクセス範囲の認識。どちらもAIに何をどこまで委ねるかの設計であり、その設計にはAIの技術構造の理解が不可欠です。

法務が禁止しようがしまいが、社員は(Heppnerがそうであったように)便利なAIツールを使おうとします。そのとき法務が「リスクがあるから様子を見てしばらく全面禁止」で押し通すのか、「このサービスはシングルテナントで動くエンタープライズ版で、規約上も訓練利用・第三者開示がないから、この範囲で利用可。弁護士関与の場合は、秘匿特権を確保するためにも以下の手順を踏むこと」と、適切な利用設計を素早く組むのか。前者は、法務としての役割放棄と言っても過言ではないでしょう。

Heppner事件は、AIの脅威を示した判例ではありません。AIの技術を知らずにAIのリスクを語ることの脅威を示した判例です。リスクを叫ぶなら、まず仕組み・技術を理解し、そこに法や契約を掛け合わせたときに発生するであろう事象を正確に予測できるようになってからです。
 

統計・確率では導けない「法的に正しい判断」を、AIでどう実現するか?ーSymbolic AIとDeontic Logic

近年、契約書レビューやリスク分析に“AI”を導入する企業が増えています。

しかし、その多くは統計的手法(機械学習・深層学習)を用いて「過去の膨大な契約文書からパターンを学習し、危険ワードをハイライトする」「確率的にリスクを推定する」という仕組みが中心です。もちろんこれは有用ではあるものの、法務実務には「確率50%だからセーフ」などという曖昧さが許容されない領域も多々存在します。

そこで注目されるのが、Symbolic AI(記号的AI) と Deontic Logic(デオンティック・ロジック) の組み合わせです。これらは「確率」ではなく「ルール」と「義務・禁止・許可」の概念をベースに、“法的に正しい判断” を機械に実装するアプローチといえます。

IMG_6288

統計的AIの限界―「確率」に頼れない法務の世界


統計的AIは、大量のデータを学習して「類似事例が何%の確率でリスクを伴う」など、確率論的に予測する手法です。たとえばメールのスパム判定などはこれで十分機能し、「95%の確率でスパム」と推定されれば実用上はほぼ問題ありません。

しかし法務の現場では、「60%の確率で安全そうだから契約条件を満たしていることにしよう」とはならないのが実情です。義務や禁止事項が明示されている場合、確率ではなく“ルールを守る・守らない”が問われる からです。

契約書に「秘密保持義務を負う」と書かれていれば、たとえ確率が低くても違反は違反。そこに統計上の“グレー”を挟む余地は少ないといえます。

この問題を解決するのが、Symbolic AIとDeontic Logicです。

Symbolic AIとDeontic Logicを組み合わせスマートコントラクトの壁―0/1の条件分岐を超える


Symbolic AI は、ルール(規則)を明示的にプログラムとして書き込む手法です。たとえば交通ルールをAIに実装するとき、「赤信号では進んではならない(禁止)」「青信号では進んでもよい(許可)」「緊急車両が来たら道を譲らなければならない(義務)」のように、人間が定義した“正しいルール” をそのまま組み込みます。

Deontic Logic(デオンティック・ロジック)は、こうした「義務」「禁止」「許可」といった規範的概念を論理式で扱う体系です。契約や法令に書かれている「〜しなければならない」「〜してはならない」を、コンピュータでも理解可能な形に落とし込めるため、単なるYes/Noの条件分岐を超えた“規範的ルール” を機械に扱わせることができます。

ブロックチェーンの普及に伴い実用化が期待されてきたスマートコントラクトは、「ある条件が満たされたら自動的に契約を実行する」という仕組みです。これは金融決済などシンプルな分岐条件の自動化には向いています。しかし、多段階の例外処理や「裁判所からの命令があれば義務を優先する」「会社の取締役会が合意すれば途中解約を認める」など、現実の契約が内包するグレーゾーンは扱いづらいという欠点がありました。

Symbolic AIとDeontic Logicの組み合わせなら、「特定の条件下ではこの禁止を一時的に解除する」「両当事者が別の義務を優先する」など、多数の例外が論理的に衝突する場面でも、優先順位や例外規定 をあらかじめルールとして設定し、機械に解釈させることが可能になります。

いわば「0/1の単純な条件分岐を超える」「確率ではなくルールベースで、複数の選択肢から法的に正しいものを導き出す」方向へ拡張できるのです。

企業法務へのメリット―例外と優先順位をさばくAI


企業法務では、NDAのように「基本は禁止だが権限者が認める場合は例外処理を許可」「法令遵守のためには別の義務が優先」など、二重三重のルールが込み入った契約や社内規程が当たり前です。学校の宿題の例に例えるなら、「毎日やるのが義務、ただし病気の場合は期限を延長してよい」のように、その時々の優先順位に応じた、柔軟な運用が求められます。

Symbolic AIとDeontic Logicを使えば、「禁止を破るほどの例外要件が生じた場合に許可が発動し、さらにその許可は別の義務より優先される」というマルチステップの推論を機械に行わせられる可能性が出てきます。これによって「法的に正しい」かつ「企業内規程とも整合性がある」判断を自動サポートできるようになります。

統計・確率ベースのAIは、大量のデータを迅速に分析する強力な武器ですが、法務の現場では「確率的に半分OK」では済まされない状況が多々あります。

Symbolic AI と Deontic Logic を駆使し、0/1の条件分岐や確率論を超えた「義務・禁止・許可」「例外や優先順位の多層的関係」を機械に理解させる取り組みアプローチは、スマートコントラクトの限界を補完し、企業法務における複雑な契約書や社内ルールの矛盾を解消しうると考えます。
 

2030年の企業法務と「AIエージェント」

商事法務のNBL 2025年1月1日号に、新春座談会「AI時代の法務—人に焦点を当てて」が収録されています。

三菱商事インハウスローヤーの鈴木卓先生からの「AIによって企業法務はどう変わるか?」「非専門家がAIを使って法的検討や判断をできるようになる『法務の民主化』は起こるのか?」をテーマにした問いの数々に、AI契約レビューサービス4社の代表がそれぞれ意見をぶつけ合う、全22ページのボリュームたっぷりな座談会です。

IMG_6178

AIリーガルテックの直接の競合同士ということもあってか、全体としてはおとなしめの・常識的な発言が多いかなという印象ですが、個人的には、MNTSQ代表の板谷隆平先生の発言が飛び抜けてキレキレで、共感を覚えるポイントが多々ありました。

企業はなぜ内部に法務部門を置くのか


その板谷先生の発言の中でも、私が特に注目したのが以下のやり取りです。

鈴木 2030年というと遠い未来のように感じますが、もう5年後になります。では、5年後どうなっているでしょうか?
板谷 私は(中略)、会社全体をエージェントが動き回って、真に法務が審査する案件を探してくる世界が来ると思っています。つまり、AIというのは標準化する技術ですので、やはり標準から離れるには人間の介入が必要になると思うのですけれども、標準とは異なるリスク、あるいはビジネス的にユニークネスがある案件をエージェントが探し出してきて、法務に手渡しするという世界が来ると思っています。

企業が法務部を設置する意味・価値というのは、突き詰めれば「リソース有限な経営者に代わって、能動的に社内外の法的リスク情報を集め、優先度を判断しながら一定のリスクは自動的に処理し、重大なリスクは直ちに報告し経営判断を仰ぐ」体制ができる点にあると考えます。この点はおそらく皆さん異論はないでしょう。

これに対し、外部の法律事務所のみに頼っている体制の限界は、"社内の法的リスク情報"についてはどうしても外部からは能動的にアクセスできない・察知しにくい、という点にあるでしょう。時折話題になる法務アウトソーシング論の限界も同様にここにあります。

こうした背景を踏まえると、経営者の“代理”としてリスク情報を逃さず拾い上げる仕組みは企業内部になくてはならないわけです。そして、板谷先生が指摘するように、普通は見逃してしまうような社内の法的リスク情報を漏れなく集め分析する役割は、人間よりもAIエージェントの方が優れているだろう、と思うのです。

会社全体をエージェントが動き回って、真に法務が審査する案件を探してくる世界


具体的な事例で考えてみましょう。

たとえば、取引先J社の重要幹部N氏に気に入られることを目的として、自社社員W氏をN氏との酒の席に同席させ、性接待に供するテレビ局があったとします。

「社員を接待に同席させる義務を負う」と真正面から記載された取引先J社との契約書のレビューが法務部門に依頼されたり、事業部から「うちの社員Nを接待に同席させて、Nさんににちょっと色目を使わせるぐらいは問題ないですかねー」といった法務相談があったりすれば、異常事態に事前に気づけて助かりますが・・・普通に考えて、そんな依頼や相談が法務部にもたらされるはずがありません(笑)。

むしろ、被害社員からのSOSすら組織的に隠蔽されるのが残念ながら世の常。そんなことはあってはならないと、いくら法務研修で啓蒙し、組織を浄化しようとしたところで、そうした情報が漏れなく能動的に報告されることは期待できないでしょう。

でも例えば、

・当社はJ社に制作コンテンツ(≒売上高)の多くを依存している
・J社の重要幹部N氏をキーマン条項に定める契約書が複数件結ばれている
・N氏との会合を目的に当社幹部Aが高級ホテルのスイートルームを借りた領収書付経理伝票がある
・スイートルーム予約日の翌日、W氏から上司Bに対し相談を持ちかけたチャット履歴がある
・その直後、W氏が病欠・長期休暇に入った
・W氏の病欠・休暇理由の明確な記録が人事データベースに存在しない

このような状況と情報をタイムリーに察知・俯瞰・分析し、取引先J社N氏と社員W氏間で何らかの重大なトラブルが発生し、それを事業部や人事部が隠蔽しているのではないかというアラートを、法務・コンプライアンス責任者に発してくれる法務AIエージェントがあったらどうだろう、ということです。

現在でも一部の企業では、社内インフラ上のキーワード解析や支出データクロス集計などが進んできています。2030年という時点を考えれば、社内のさまざまなシステムが連携し、AIエージェントが違和感のある異常値や文脈を捉えてアラートを出すことは、技術的にそれほど遠くない未来だと言えるでしょう。

2030年法務AIエージェントは実用レベルに達するか――根拠と懸念


座談会は、「AIの普及によって人(特に社内弁護士)の価値やチャンスはむしろ高まる」という楽観的な結論で締め括られています。

しかし私は、以下の点から、2030年時点で、テキストベースの業務に終始していた法務業務の多くの部分がAIエージェントに代替されているシナリオは十分あり得ると思っています。

1.自然言語処理(NLP)の加速度的進歩:
現在の生成系AIの台頭によって、長文のレビューや文脈理解が既に実務レベルに達しつつある。

2.ビッグデータ分析とクラウド環境の成熟:
従来は膨大なデータを一括で処理することがコスト的にも技術的にも困難だったが、クラウド技術の普及により、社内の複数データソースを一カ所に集めて解析する体制が整いつつある。

3.部門横断のデータ連携ニーズの高まり:
経理・人事・営業・法務といった縦割りからの脱却が多くの企業で課題となり、そこをAIが橋渡しする動きはDX(デジタル・トランスフォーメーション)の流れのひとつ。

もちろん、データの取り扱いやプライバシー保護のルールをどこまで整備するか、またシステム導入コストや人的リソースの再配置といった現実的課題も並行して生じます。AIエージェントがあまりに企業内のあらゆる情報にアクセスすることは、社員の監視強化という負の側面にもつながりかねません。

しかし、「経営者を代理して法的リスクを収集・処理する」のが法務部の存在意義であることを考えると、経営者の立場からはそうした困難を乗り越えてでもAIエージェントに(文字通り)代替させようとするのが自然では、という思いを強くしているところです。

次回予告 契約法務の領域は自然言語から逃れられないのか?


座談会の中では、AIエージェントによる代替が難しそうな法務領域はどこか?という文脈で、このようなやりとりもありました。

鈴木 『Legal Operationsの実践』の座談会の中で、LINE Yahoo!の齋藤国雄さんが「自然言語は時代遅れなのかと思っていた」という場面がありました。(380ページ)。そう思っていたけれども、生成AIが出てきて、読解力がもう一度脚光を浴びると思うようになった、つまり、ある程度のボリュームの文章をきちんと読み解く力が重要になる、ということをおっしゃっていて、その時は、難しいことをおっしゃるなと思っていたのですけれども、つまりは、そういうことなのかもしれないと思うんです。 AIは答えてくれるけれども、やはり言葉をしっかり読んで理解して、それをまた自分の言葉で伝えることというのが、結局また大事になってくるのではないかという気がしています。
板谷 そうですね。少なくとも契約法務の領域は、言語からは決して逃れられないでしょうね。スマートコントラクトなどと言われていますけれども、必ず自然言語を処理する部分は残るとは思います。

私も数年前まではそう思っていたのですが、この契約法務における自然言語依存問題を解決しうるアイデアがあることを最近知り、考え直すに至っています。

この点についてはまた次回に。

法務&知財系ライトニングトーク2017 <リーガルテック祭>を開催しました

 
法務&知財系ライトニングトーク2017 <リーガルテック祭>が無事終了。ご参加者のみなさま、そして@kataxさんはじめクックパッドのみなさま、@shibaken_law先生、お忙しい中お集まり&ご協力をいただいただき、本当にありがとうございました。


LTの企画担当として、今回、いつもの「法務・知財のことならなんでも話したいことどうぞ」をやめて、LTしていただくテーマをある程度絞り込んでみるというTRYをしてみました。その効果として、エンジニア・官公庁勤務・フリーランスの方など、参加者の方の顔ぶれ・ご所属がいつもよりさらにバラエティに富んだものとなりました。

一方で、テーマにエッジを立てた分各LTの内容があまりにも個別性高くマニアックになってしまうおそれもあったことから、網羅性が担保できるよう、基調講演的なLTを設けるというTRYも。こちらは、日本でいち早くリーガルテックを事業として実践されている弁護士ドットコムクラウドサイン事業責任者の橘先生と、弁理士で株式会社Toreru代表の宮崎先生にお願いをしました。

IMG_9709
弁護士ドットコム橘先生

IMG_9711
株式会社Toreru宮崎先生

5分ずつという短い時間ながらきっちりとリーガルテックの全体像・日本の現在地・基本的な効用を実践者としての実感値を交えてお話いただいたことで、イベント全体にいい流れを作っていただけたと思います。本当にありがとうございました。


GitHub/支援型・代替型AI/2of3マルチシグ/とりあえず聞いてみる・やってみる/デザイン思考とカスタマー志向/グラフ構造分析/モジュール化とオープン化によるフェアネス担保/自動化≠利益化/エンジニアが法務を担う/紛争を発生させないことで利益を生み出す法務/すべての課題は国会に通じる/電子化の4つの場面(交付・署名・申請・保存)・・・LTを聞いてないとなんのこっちゃかもしれませんが、私が司会の片手間に刺激を受けてメモしたフレーズ・キーワードだけでもこんなにあり、5分のそれぞれのLTがいつも以上に短く・早く感じました。

リーガルテックが産業としてくるかこないかはさておいても、何より感じたのは、法務パーソンに語学力が求められてきたようにテック力が当たり前に求められるようになるのはまず間違いないな、ということでしょうか。脅威でもあり、楽しみでもあります。
 

当日の様子はtwitterのハッシュタグ #LegalTechLT からご覧いただけます。ご参加者のご感想もお聞きしたいですし、こちらをご覧いただきリーガルテックに興味をもったという方もぜひ私までお声かけください。またこういったイベントも随時開いていきたいと思っていますので、その際はどうぞご参加とご協力をお願いいたします。
 

リーガルテックと10年後の法務・知財業務

 
このエントリでは、10/5開催予定のリーガルテックLTに向けた準備と論点整理も兼ねて、法務・知財業務の人から機械への業務代替可能性や、企業法務・知財パーソンが今後力を入れていくべき領域について、考えてみたいと思います。

「人ならではの仕事」を特徴付ける3つの要素


リーガルテックの未来に関する論考をいくつか読んでみた中で、人ならではの機械には代替されにくい仕事とは何か、人と機械のすみわけについて、ビジネス法務2017年7月号の特集「リーガルテックの最前線」に掲載された野村総研上田恵陶奈さんの記事(P12-16)が分かりやすく参考になりましたので、一部を紹介させていただきます。

(オックスフォード大と野村総研の)共同研究では、AIは一部の職業を代替できる可能性があるが、代替できない職業もあるという結果になった。では、AIが技術的に自動化しにくい、苦手とする特徴とは何か。要約すると、「創造性」「ソーシャル・インテリジェンス」「非定型」という特徴がある場合である(下記【図表1】)。逆に言えば、「創造性が必要ない」「ソーシャル・インテリジェンスを必要としない」「定型」の特徴を持つ職業は、AIなどで代替できる可能性が高い。

busihou2017july

McKinseyの調査によれば、現時点のテクノロジーを前提とした場合、全職業では約半分の業務が自動化可能であるけれども、弁護士については23%の業務のみが代替可能とされる。Deloiteは、今後20年で弁護士事務所人員の39%が代替可能と予想している。代替できる範囲に違いはあるが、いずれも2つの点で共通している。すなわち、法律事務所の業務はAIによって自動化される可能性があることと、代替できる範囲は半分未満にとどまり人による業務と共存することである。

野村総研の上田さんは、記事全編にわたり、法律業務の多くは(プロフェッショナル集団である法律事務所であっても)テクノロジーによって代替されていくが人に残る領域はあり、機械と仕事を奪い合うのでなくテクノロジーをうまく使いこなす側にまわることで、人ならではの3つの特徴を生かした高付加価値業務にシフトを進めるべきだ、と述べています。

ではその高付加価値業務とは何か、代替されない業務とは何かを具体的に見極めて、将来求められるであろう経験・スキルを今から戦略的に身につけていきたいところです。

法務・知財の業務別代替難易度


そこで私は、法務・知財の求人広告に記載されている業務をリストアップし、それらを先に紹介した「創造性/ソーシャルインテリジェンス/非定型」の3つの切り口で、私の独断によるテクノロジー代替難易度をランク付けしてみました。特に、Aが2つ以上ついたものは代替可能性はかなり低い(できたとしてもシンギュラリティ以降)だろうということで二重丸を、Aが1つついたものも今後10年は代替困難だろうということで一重丸を、それぞれつけています。

daitainanido2

こうやって眺めてみると、現時点で「C」ランクを付けざるを得ない業務は、実はすでになんらかの形(法律特許事務所・サービサー・請負事業者への委託、派遣社員の活用、システム化)で代替・アウトソースがはじまっている領域であることがわかります。これらの業務が人の手から離れ、ますます機械化されていくであろうことについては、それほど異論はなさそうです。

一方、議論が分かれるのは「B」ランクの業務でしょう。特に、現状の法務・知財パーソンのメイン業務である契約書・特許出願書類等の法律文書作成業務は、業務時間に占めているボリュームが多いだけに、本当に代替されてしまうのかは興味深いところです。この点、当然に案件によって創造性がアウトプットの差を生んだり、非定型で複雑な処理が一部混入していることで機械化がかえって非効率になったり、ということはあるでしょう。しかし、そういった特殊なものを取り除いた大部分が機械で自動化可能ならば、これらの業務も早晩テクノロジーに代替されていくのだと思われます。

そうなると、がぜん「A」ランクが付く業務に注目が集まってきます。法的リスクを早期に発見・切り分けしこれを乗り越えていくための法律・知財相談、人間の感情が交わるからこそ機械だけでは手には負えない訴訟・トラブル・危機管理、そして近年法務の領域拡大エリアとして注目を集める法そのものを動かしていく渉外・公共政策・・・、いずれも、法的トレーニングを積んだ基礎があった上での総合芸術的な業務分野です(水野祐先生が提唱される「リーガルデザイン」の目指すところと多くが重なります)が、この辺の業務の経験を今から積極的に取りに行き、自分の血肉としていく行動力が求められます。

テクノロジーで生まれる余力でシフトチェンジ


法曹人口の拡大による契約書業務の低価格化に危機感を感じこのブログを始めた12年前、契約書作成半自動化サービス「契助」がリリースされてアメリカでもLegalZoomやRocketLawyerといったテック系企業が勃興しはじめた4〜5年前、そして日本でもAIを用いたリーガルテックサービスが矢継ぎ早にリリースされはじめた現在。ゆっくりとしかし確実に業務自動化の足音は近づいてきています。

約10年後の2030年、B〜Cランク業務の多くがテクノロジーによって代替される(かもしれない)未来に備え、自分から積極的にテクノロジーを手懐けてCランク業務を省力化し、生まれた余力でクラッチを切っていち早くAランク業務へシフトチェンジしていく。そんな戦略が理想的です。
 

ビジネス法務 2017年 07 月号 [雑誌]
中央経済社グループパブリッシング
2017-05-20


法務&知財系ライトニングトーク2017 <リーガルテック祭> へのご応募ありがとうございました


10月5日開催、「法務&知財系ライトニングトーク2017 <リーガルテック祭>」 へのご応募ありがとうございました。受付開始から数日で定員の2倍を超え補欠繰り上がり待ちの方も出るなど、このテーマに対する関心の高まりを改めて感じました。

イベントページにも追記させていただきましたとおり、基調LTには、弁護士ドットコム「クラウドサイン」事業責任者 橘大地先生と、株式会社Toreruの代表取締役 宮崎起史先生をお招きします。橘先生には日本のリーガルテックの全体像について、宮崎先生には人工知能が変える知財の将来について、それぞれお話していただくことになっています。

2017-09-08-21-05-58
2017-09-08-21-06-47

※橘先生・宮崎先生のご経歴・ご活躍については、以下記事を参照
▼1年半で6,000社が導入!「PMF」を実現した、新規サービスの開発・拡大プロセスを公開
https://seleck.cc/959
▼書類作成の9割以上自動化、作業量従来比1/10に。商標登録AI「Toreru」
http://startuptimes.jp/2017/08/07/62452/

また、一般応募枠で参加いただける企業や法律事務所の方々にも、(私からは公開を控えますが)リーガルテックを活用される会社様や、この分野で著名な先生がいらっしゃいます。どうぞお楽しみに。LT参加の方でテーマをご提出いただけてない方、イベントページでの表示が「(未定)」になっておりますので、こちらのご提出もお待ちしております!

最後に、残念ながら補欠となってしまったみなさま、法律系イベントのキャンセル率は低めなので、申し訳ないのですが繰り上がりは期待薄でご参加いただけない可能性が高いと思います。。。どの程度お伝えできるかはわかりませんが、可能な限りハッシュタグ #LegalTechLT でtwitter実況を試みたいと思います。

どうぞよろしくお願いいたします。

法務&知財系ライトニングトーク2017 <リーガルテック祭>  8/29からLTer受付開始


来たる2017年10月5日(木)、 ブログ「企業法務について」の @katax さんと、法務&知財系ライトニングトーク(LT)イベントの開催を企画しています。

今回は、いつもと違った新しい試みとして、LTのテーマをあらかじめ設定してみたいと考えています。
そのテーマはずばり「リーガルテック」。

IMG_9027


クラウド・ビッグデータ・AI・ブロックチェーンといったテクノロジーが次々と法律業務にも応用されつつある現状を踏まえ、
・実務に業務にどう取り入れていくか?(具体的アイデアでも期待・想像でもOK)
・あの会社のリーガルテックサービスを実際に使ったことあります!(感想・レビュー)
・あなたが予想するリーガルテックの落とし穴・リスク
・人間が活躍できる非代替領域はどこになるのか?
・リーガルテック時代の法務・知財パーソンの今後のキャリアは?
・行政サービス・法律はどう変わっていくか?
など、リーガルテックに関連したテーマで5分間のLTをご披露いただければと思います。なお、基調講演(LT)として、実際にリーガルテックを推進されている事業者・専門家の方々にお話をいただくことも検討しています。

リーガルテックに対する「期待」や「不安」はさまざまあると思いますが、企業の中で法務・知財として今も活躍する皆さんがテックを使いこなし、より生産性や付加価値の高い業務に取り組む前向きな未来について、ピザとビールを片手に気軽に意見交換・想像できるような場にできればと考えています。

そこで、現在企業に在籍されている法務・知財パーソンの方々から、LTerを12名程度優先枠として先行受付させていただきたいと思います。応募方法について、あす8月29日(火)7:00ごろから9月3日(日)ごろまでをいったんの優先申込み期間として、本記事内に応募フォームへのリンクを掲載いたします。予定を変更し、8/29から企業在籍LTer枠12/士業その他LTer枠6/聴講枠をそれぞれ先着順で受付を開始しました。

ご興味を持ってくださった方は、お手数ですがご応募いただければ幸いです。


▼法務&知財系ライトニングトーク2017 <リーガルテック祭>(connpass)
https://connpass.com/event/65612/


ビジネス法務 2017年 07 月号 [雑誌]
中央経済社グループパブリッシング
2017-05-20


FinTechの法律 2017-2018 (日経FinTech選書)
森・濱田松本法律事務所 増島雅和
日経BP社
2017-07-21


記事検索
月別アーカイブ
プロフィール

はっしー (Takuji H...